관계형 데이터베이스 [개념]
1. 관계 (relation)
1.1. 수학에서 relation
-
집합 (set)
- 서로 다른 객체(원소)의 모임
- 데이터가 중복되지 않도록 보장하며, 보통 빠른 검색과 삽입을 위해 설계된 자료구조
- 하나의 set에서 elements의 순서는 중요하지 않다.
-
관계 (relation)
- 카테시안 곱의 부분 집합 (subset of Cartesian product)
- 튜플들의 집합 (set of tuples)
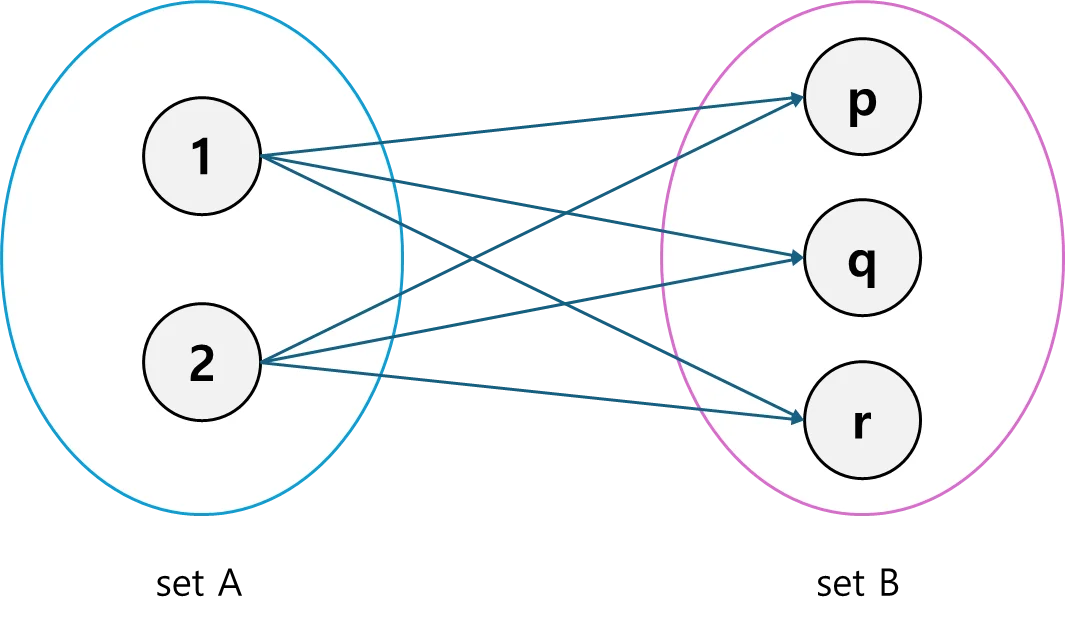
-
set A와set B에서 각각 원소를 하나씩 골라 만들 수 있는 모든 쌍들의 집합(1, p), (1, q), (1, r), (2, p), (2, q), (2, r)
-
- 이항 관계 = A와 B의 카테시안 곱의 부분 집합
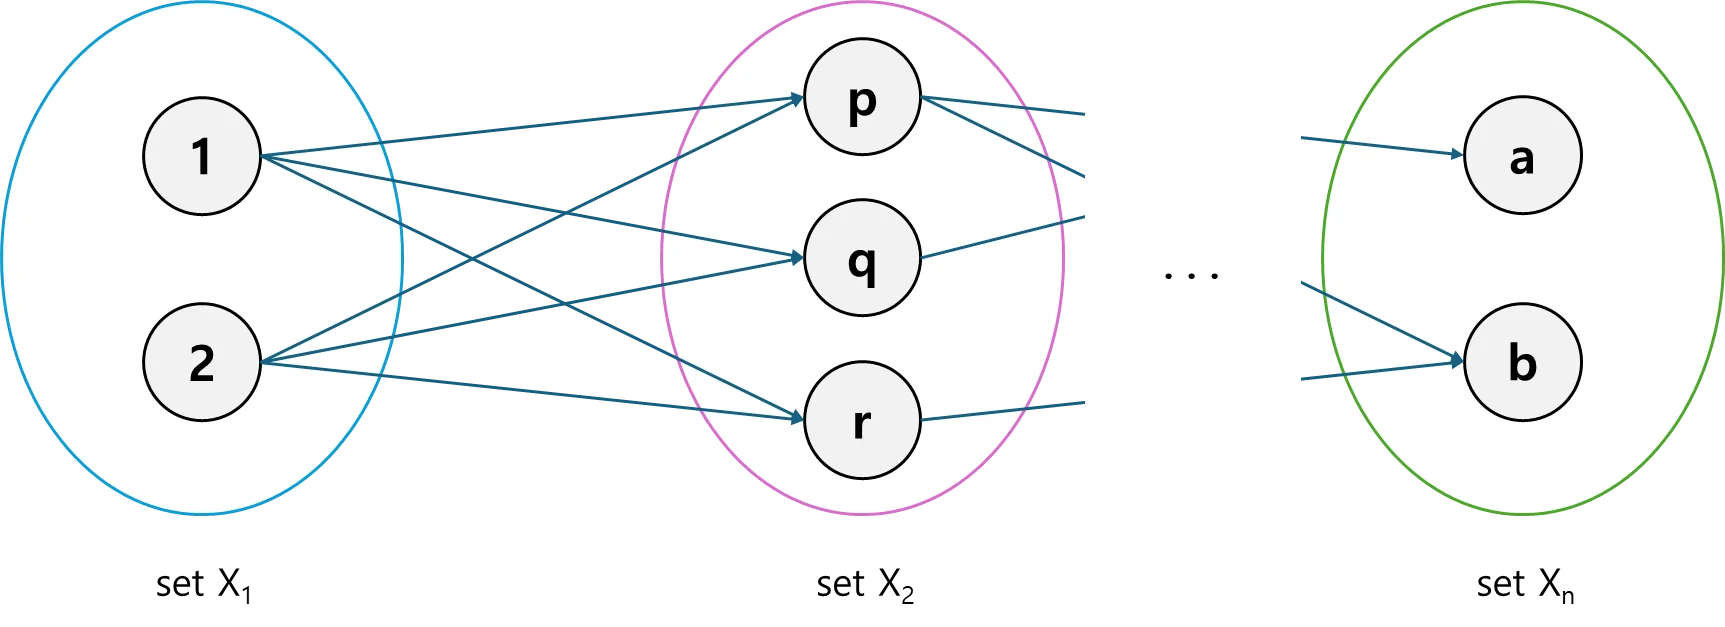
-
- 셀 수 있는 수량의 요소들을 순서에 따라 나열한 것으로, 개의 요소를 가진 튜플
1.2. 관계형 모델에서 relation
-
관계형 모델에서
set은domain을 의미 -
student relation을 예로 들어 relational data model을 이해해 보자.- 학생 관계의 도메인 정의하기
도메인 이름 (Domain Name) 설명 (Description) 값의 유형 (Value Type) students_ids학번 집합 7자리 정수 (7-digit integer) human_names사람 이름 집합 문자열 (String) university_grades대학교 학년 집합 정수 집합 {1, 2, 3, 4} (Set of Integers) major_names대학교에서 배우는 전공 이름 집합 문자열 집합 (Set of Strings) phone_numbers핸드폰 번호 집합 문자열로 표현된 숫자 (String of Digits) 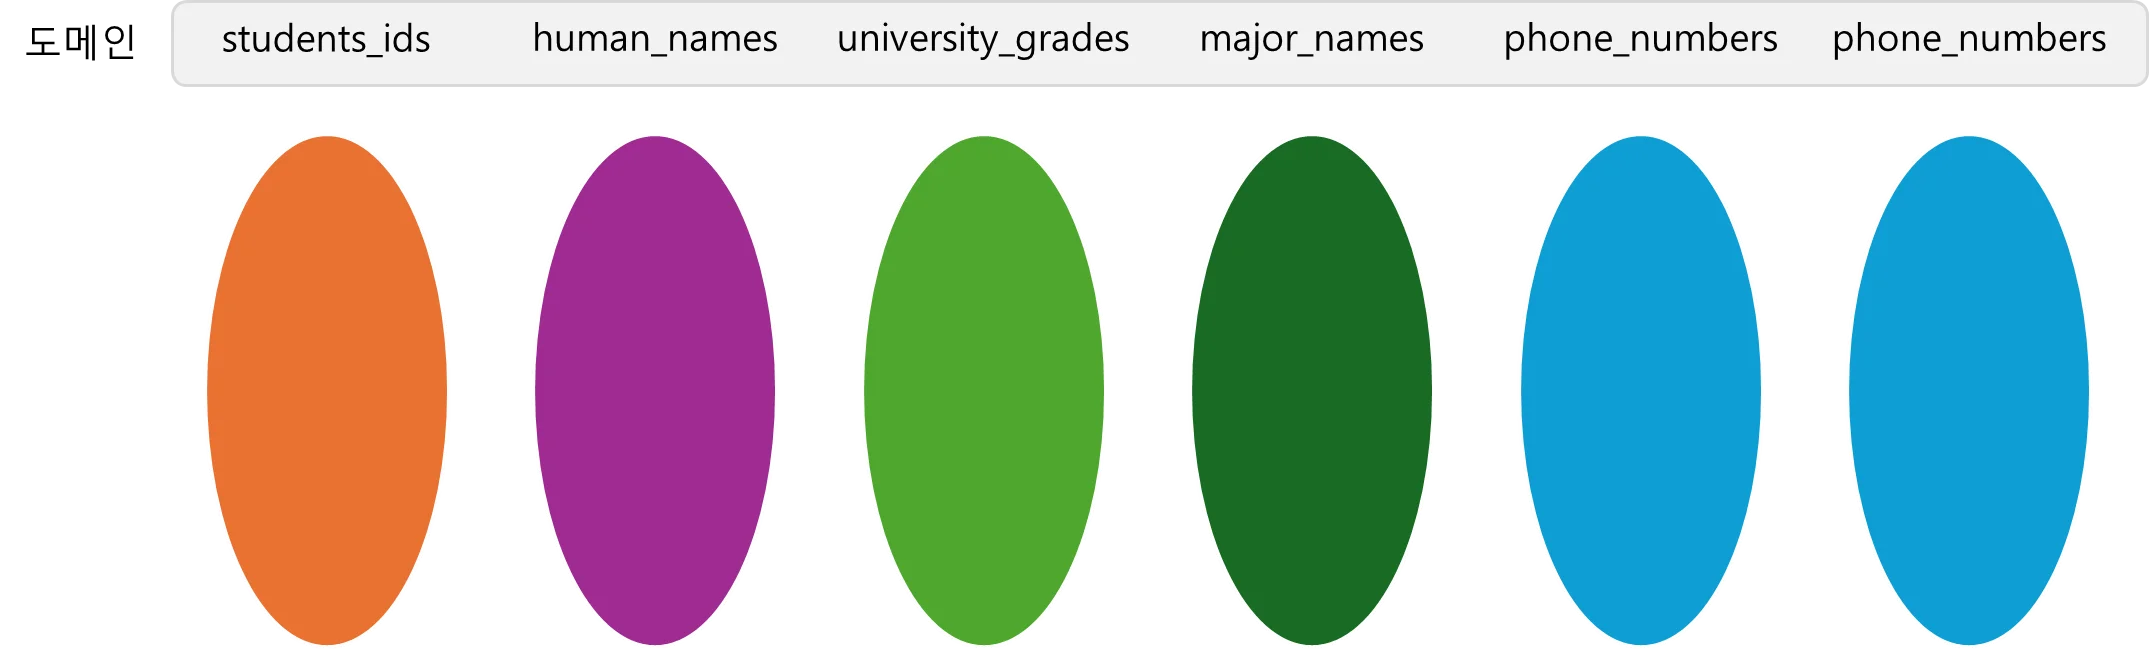
-
만약 본인의 휴대폰 번호 외에 비상 연락망도 추가 해야 한다면 어떻게 해야할까?
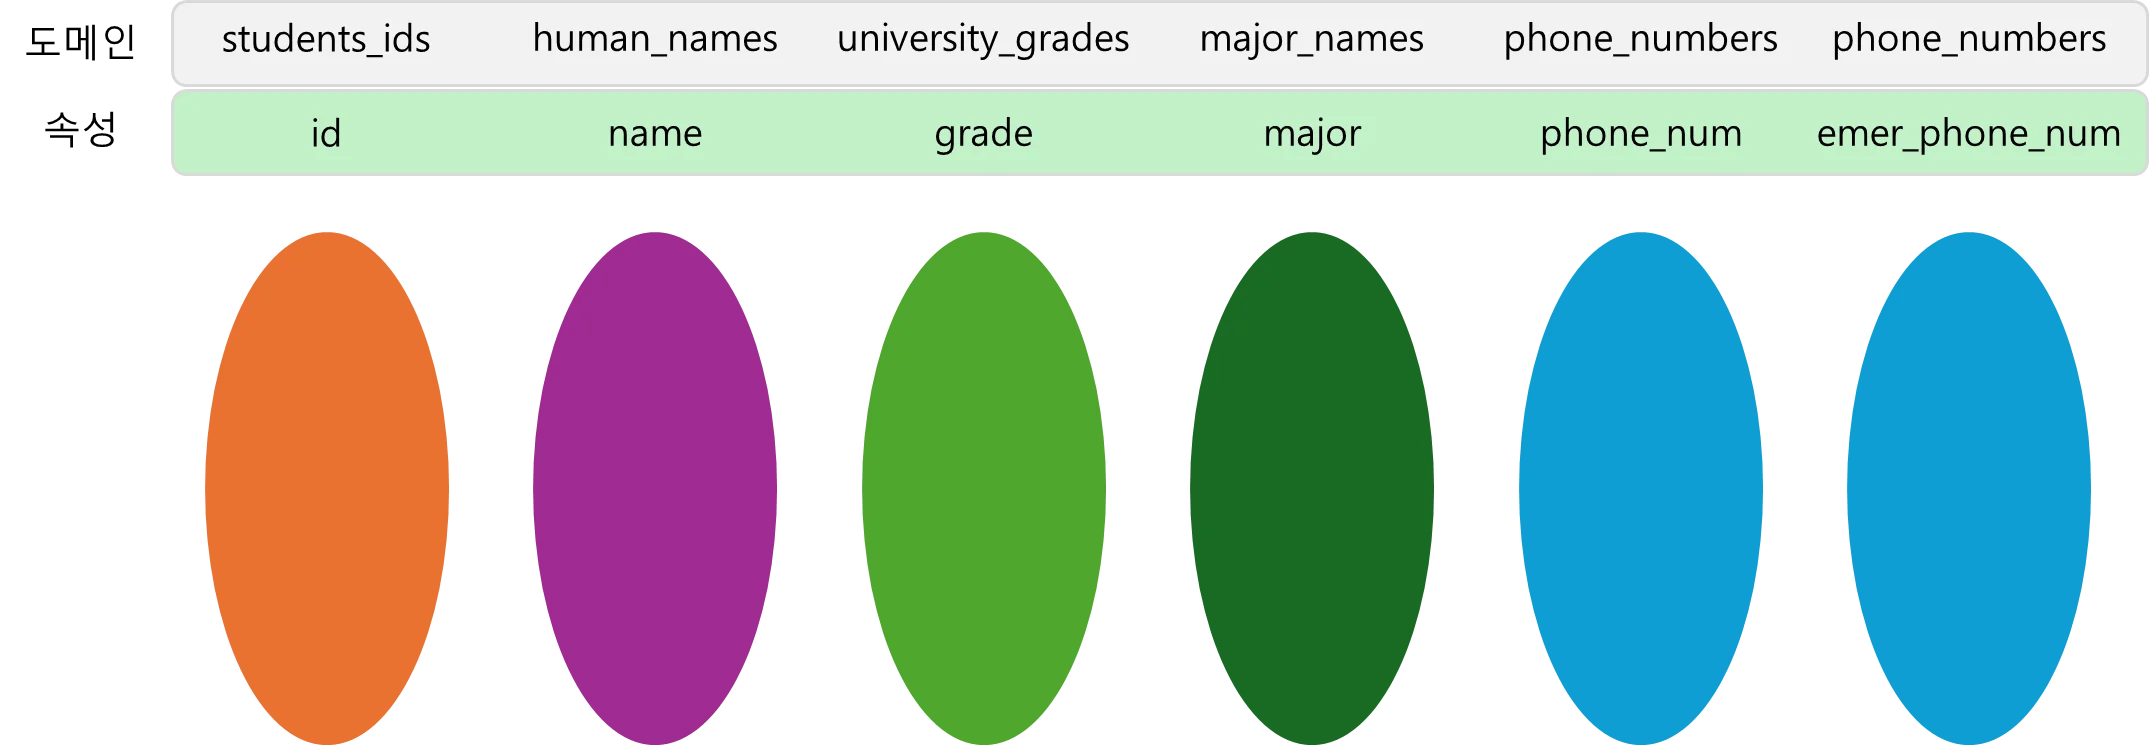
phone_numbers라는 도메인이 본인의 휴대폰 번호와 비상 연락망 모두에 사용되므로 구분이 필요- 이를 해결하기 위해 **속성(attribute)**이라는 개념을 도입
- 동일한 도메인(phone_numbers)을 사용하지만, 속성을 추가하여 각 값이 어떤 의미를 가지는지 구분
- 예시 속성
phone_num: 본인의 휴대폰emer_phone_num: 비상 연락망
- 속성을 통해 동일한 도메인에 다양한 의미를 부여함으로써 중복 문제를 해결하고 데이터의 의미를 명확히 한다.
-
학생 관계에서의 튜플
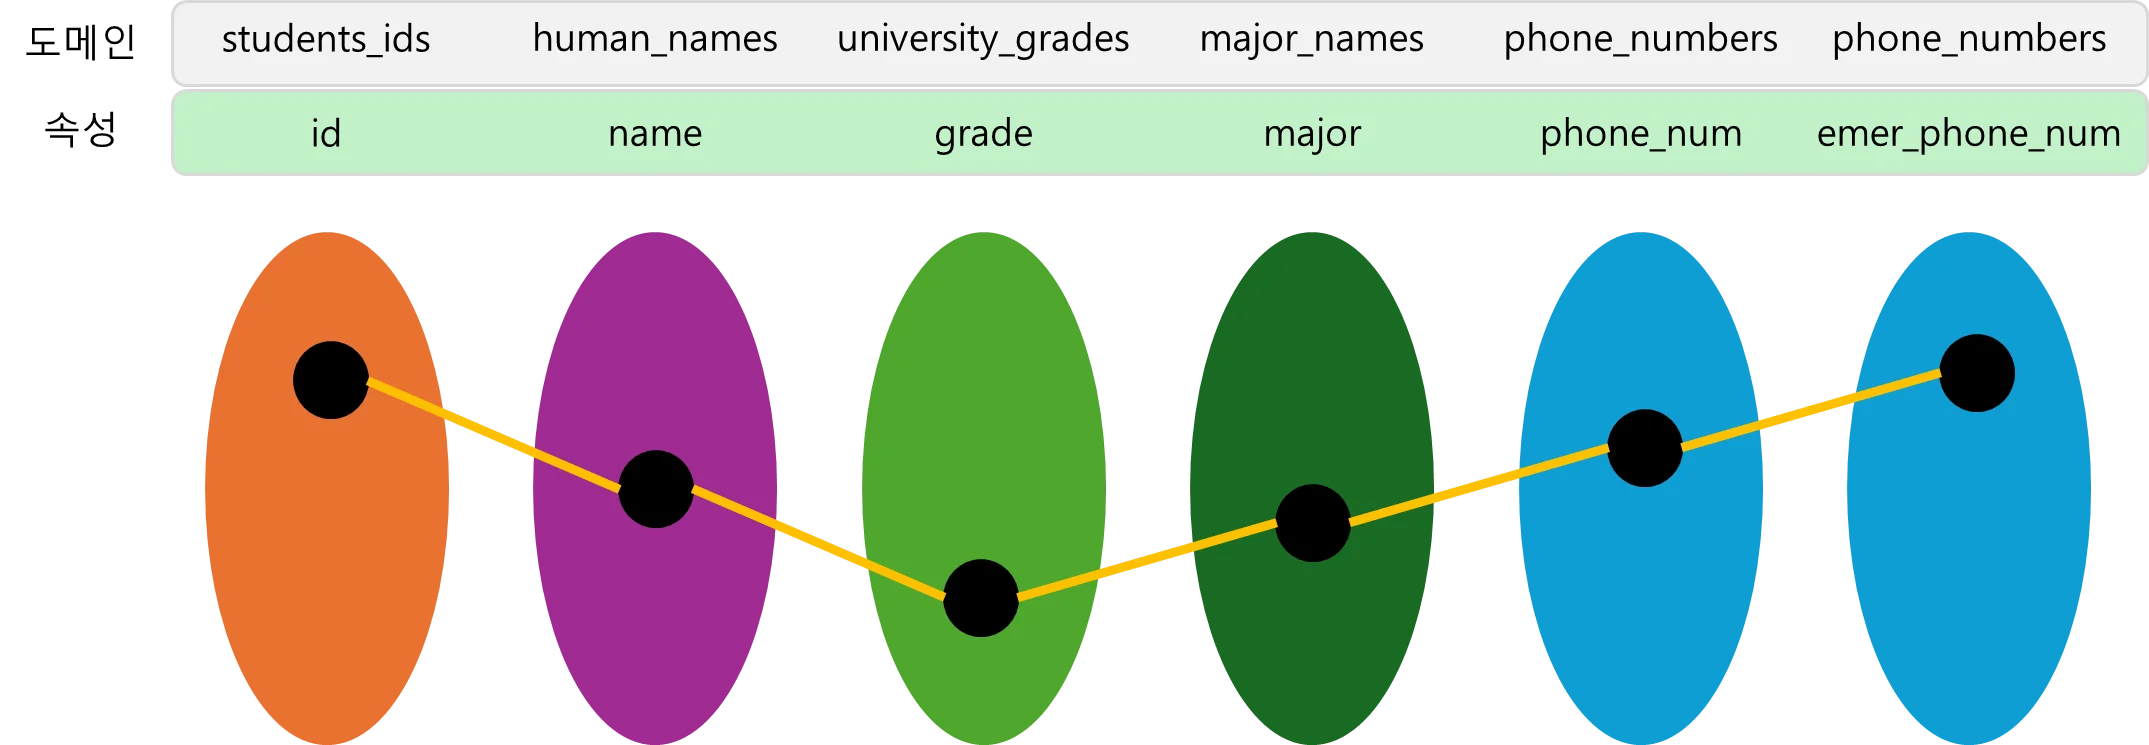
- 학생 관계의 속성별 집합 중에서 각 속성에서 하나씩 값을 선택하여 구성된 것을 튜플이라고 한다.
- 예)
(2023001, "김철수", 3, "컴퓨터공학", "010-1234-5678")
- 예)
- 학생 관계의 속성별 집합 중에서 각 속성에서 하나씩 값을 선택하여 구성된 것을 튜플이라고 한다.
-
관계형 데이터 모델에서의 학생 관계
-
이 튜플들을 가장 잘 설명할 수 있는 방식이 테이블 형태로 나타내는 것
id name grade major phone_num emer_phone_num 2023001 김철수 3 컴퓨터공학 010-1234-5678 010-3462-1536 2023002 이영희 2 경영학 010-8765-4321 010-5821-5685 2023003 박민수 1 전자공학 010-2345-6789 010-4859-1892 - **관계 이름(Relation Name)**은 STUDENT
- **튜플(Tuple)**은 테이블의 한 행(Row)을 구성
- **속성(Attribute)**은 테이블의 각 열(Column)을 구성
- 여러 튜플들이 모여 하나의 관계(Relation), 즉 테이블을 형성
-
-
정리
주요 개념 설명 도메인 (Domain) set of atomic values * atomic - 더 이상 나누어질 수 없어야 한다. 도메인 이름 (Domain Name) domain 이름 속성 (Attribute) domain이 relation에서 맡은 역할 이름 튜플 (Tuple) 각 attribute의 값으로 이루어진 리스트. 일부 값은 NULL일 수 있다. 관계 (Relation) set of tuples 관계 이름 (Relation name) relation의 이름
2. 관계 스키마 (relation schema)
- 관계(relation)의 구조를 나타낸다.
- 관계의 이름과 속성(attributes) 리스트로 표기된다.
- 예)
STUDENT(id, name, grade, major, phone_num, emer_phone_num)
- 예)
- 속성과 관련된 **제약조건(constraints)**도 포함한다.
- 관계의 차수(degree of a relation)
- relation schema에서 attributes의 수
- 예)
STUDENT(id, name, grade, major, phone_num, emer_phone_num)→ degree 6
- 예)
- relation schema에서 attributes의 수
3. 관계형 데이터베이스 (relational database)
- 관계형 데이터 모델에 기반하여 구조화된 데이터베이스
- 관계형 데이터베이스는 여러 개의 관계들로 구성된다.
3.1. 관계형 데이터베이스 스키마(relational database schema)
- 관계형 스키마 세트(Relation Schemas Set) + 무결성 제약조건(Integrity Constraint)
3.2. 관계의 특징
relation은 **중복된 tuple을 가질 수 없다**. (relation is set of tuples)
| id | name | grade | major | phone_num | emer_phone_num |
|---|---|---|---|---|---|
| 2023001 | 김철수 | 3 | 컴퓨터공학 | 010-1234-5678 | 010-3462-1536 |
| 2023001 | 김철수 | 3 | 컴퓨터공학 | 010-1234-5678 | 010-3462-1536 |
| … | … | … | … | … | … |
relation의 **tuple**을 식별하기 위해 **attribute의 부분 집합**을 **key**로 설정한다.
| id | name | grade | major | phone_num | emer_phone_num |
|---|---|---|---|---|---|
| 2023001 | … | … | … | … | … |
| 2023002 | … | … | … | … | … |
| 2023003 | … | … | … | … | … |
relation에서 **tuple의 순서**는 중요하지 않다.
| id | name | grade | major | phone_num | emer_phone_num |
|---|---|---|---|---|---|
| 2023002 | 이영희 | 2 | 경영학 | 010-8765-4321 | 010-5821-5685 |
| … | … | … | … | … | … |
| 2023001 | 김철수 | 3 | 컴퓨터공학 | 010-1234-5678 | 010-3462-1536 |
하나의 relation에서 **attribute의 이름**은 중복되면 안된다.
| id | name | grade | major | phone_num | emer_phone_num |
|---|---|---|---|---|---|
| … | … | … | … | … | … |
| … | … | … | … | … | … |
| … | … | … | … | … | … |
하나의 relation에서 **attribute의 순서**는 중요하지 않다.
| id | phone_num | grade | emer_phone_num | major | name |
|---|---|---|---|---|---|
| 2023002 | … | 2 | … | 경영학 | … |
| 2023003 | … | 1 | … | 전자공학 | … |
| 2023001 | … | 3 | … | 컴퓨터공학 | … |
attribute는 **원자적(atomic)** 이어야 한다.
-
복합(composite) 속성이나 다중값(multivalued) 속성은 허용되지 않는다.
id name grade major address … … … 컴공, 디자인 서울특별시 강남구 청담동 … … … 물리, 화학 경상남도 진주시 가좌동 … … … 컴공, 수학 부산광역시 해운대구 반여동 - major (전공)
컴공, 디자인과 같이 여러 전공이 하나의 속성에 나열되어 있으면, 이는 **다중값 속성(multivalued attribute)**에 해당- 전공은
전공과부전공으로 나눠질 수 있다.
- address (주소)
서울특별시 강남구 청담동과 같은 주소는 **복합 속성(composite attribute)**에 해당- 주소는
시, 구, 동등 여러 부분으로 나눠질 수 있다.
- major (전공)
3.3. NULL의 의미
-
NULL의 중의적 표현- 값이 존재하지 않는다.
- 해당 속성에 값이 아직 할당되지 않았거나, 아예 존재하지 않는 경우.
- 값이 존재하나 아직 그 값이 무엇인지 알지 못한다.
- 해당 속성에 값이 존재하지만, 그 값에 대한 정보가 누락된 경우.
- 해당 사항과 관련이 없다.
- 해당 속성이 특정 조건에서 의미가 없거나 적용되지 않는 경우.
- 값이 존재하지 않는다.
-
예시 - 토익 점수 속성의 값이
NULL인 경우:id name grade toeic_score … 김철수 … NULL … 이영희 … 912 … 박민수 … 990 - 김철수의 toeic_score가
NULL이면 TOEIC 점수가 있지만 입력되지 않은 상태일 수도 있고, 아예 시험을 치르지 않아 점수가 없는 상태로 해석할 수도 있다.
- 김철수의 toeic_score가
-
따라서 NULL의 의미는 상황에 따라 달라질 수 있으므로, 가능한 한 사용을 지양하는 것이 좋다.
4. 키(key)의 종류
4.1. 슈퍼키 (super key)
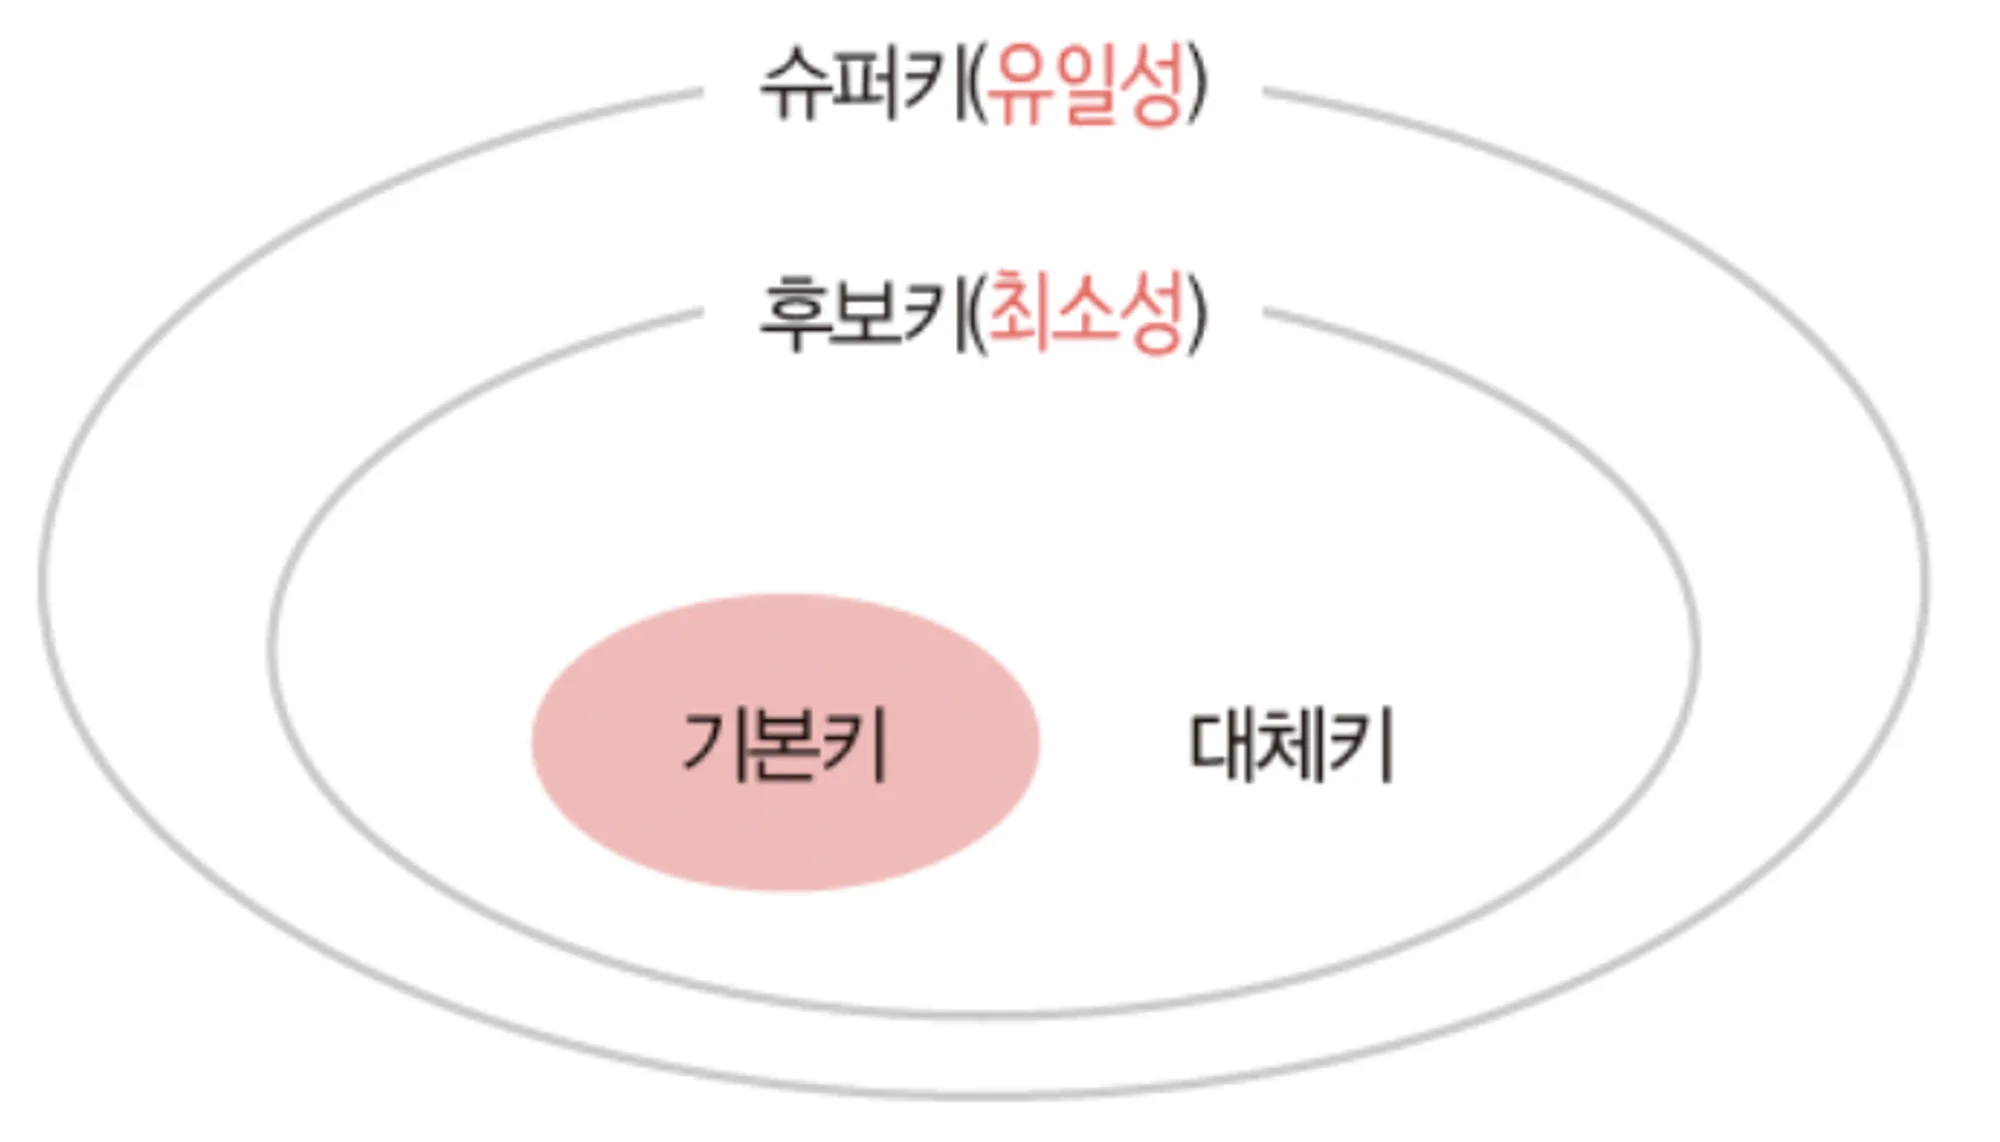
- relation에서 tuples를 unique하게 식별할 수 있는 attributes set
- 예)
PLAYER(id, name, team_id, back_number, birth_date)의 슈퍼키{id, name, team_id, back_number, birth_date}{id, name}{name, team_id, back_number}- … etc
- 예)
4.2. 후보키 (candidate key)
-
어느 한 attribute라도 제거하면 unique하게 tuples를 식별할 수 없는 super key
- 예)
PLAYER(id, name, team_id, back_number, birth_date)의 후보키-
{id} -
{team_id, back_number}* 하나의 팀에 중복된 등 번호를 가진 선수는 없으므로 후보키 성립
-
- 예)
-
minimal superkey라고 부르기도 한다.
4.3. 기본키 (primary key)
- relation에서 tuples를 unique하게 식별하기 위해 선택된 candidate key
- 예)
PLAYER(id, name, team_id, back_number, birth_date)의 기본키{id}또는{team_id, back_number}
- 예)
4.4. 고유키 (unique key)
- primary key가 아닌 candidate keys
- 예)
PLAYER(id, name, team_id, back_number, birth_date)의 고유키{id}가 기본키로 선택된 경우, 고유키는{team_id, back_number}
- 예)
- 대체키(alternate key)라고 부르기도 한다.
4.5. 외래키 (foreign key)
- 다른 relation의 primary key를 참조하는 attributes set
- 예)
PLAYER(id, name, team_id, back_number, birth_date)와TEAM(id, name, manager)가 있을 때 외래키는 PLAYER의{team_id}
- 예)
5. 제약조건 (constraints)
- relational database의 relations들이 항상 지켜줘야 하는 제약 사항
5.1. 암묵적 제약조건 (implict constraints)
- relational data model 자체가 가지는 constraints
- relation은 중복되는 tuple을 가질 수 없다.
- relation 내에서는 같은 이름의 attribute를 가질 수 없다.
5.2. 스키마 기반 제약조건 (schema-based constraints)
- 주로 DDL을 통해 schema에 직접 명시할 수 있는 제약조건
- explicit constraints(명시적 제약조건)에 해당
5.2.1. 도메인 제약조건 (domain constraints)
-
attribute의 value는 해당 attribute의 domain에 속한 value여야 한다.
-
예시) 학년을 나타내는
grade의 value로 100이 지정되어서는 안된다.id name grade major phone_num … … 4 … … 2023002 이영희 100 경영학 010-8765-4321 … … 3 … …
5.2.2. 키 제약조건 (key constraints)
-
서로 다른 tuples는 같은 value의 key를 가질 수 없다.
-
예시)
id name grade major phone_num 2023002 홍진호 … … … 2023002 손흥민 … … … … … … … …
5.2.3. NULL 값 제약조건 (NULL value constraint)
-
attribute가 NOT NULL로 명시됐다면 NULL을 값으로 가질 수 없다.
-
예시)
phone_num속성에 NOT NULL이 명시됐지만, NULL이 포함된 경우id name grade major phone_num (NOT NULL) … … … … 010-1234-5678 … … … … 010-5689-4341 … … … … NULL
5.2.4. 엔티티 무결성 제약조건 (entity integrity constraint)
-
primary key는 value에 NULL을 가질 수 없다.
-
예시)
id name grade major phone_num (NOT NULL) NULL … … … … 2022415 … … … … 2021591 … … … …
5.2.5. 참조 무결성 제약조건 (referential integrity constraint)
-
foreign key와 primary key와 도메인이 같아야 하고 primary key에 없는 values를 foreign key가 값으로 가질 수 없다.
-
예시) 존재하지 않는
team_id를 value로 사용PLAYER
id name team_id … … team_017 … … NULL … … team_023 TEAM
id name manager team_011 … … team_017 … … team_025 … …
참고 자료
이전 글
**다음 글 **