정렬 알고리즘 [개념]
•3 min read3 min•510 words510 words
Note
한 줄 정리
파이썬에서 정렬은 기본적으로 오름차순이다!
- 문자열의 오름차순 정렬은 사전순(아스키코드가 낮은 순)이다!
- 배열의 원소가
(3, 4, 5)처럼 여러 개의 값이 들어 있다면, 앞에 있는 원소를 우선적으로 비교한다. - 파이썬에서의 사용자 정렬은 key 옵션을 통해서 가능하며, 함수 형태로 어떤 값을 기준으로 정렬할 것인지 지정해 주면 된다.
1. 정렬 알고리즘
- 정렬 알고리즘이란 어떤 기준에 대해 원소들을 정렬하는 알고리즘을 의미
- 대부분의 프로그래밍 언어에선 정렬 함수를 내장 함수로 제공하고 있다.
- 오름차순과 내림차순 정렬의 경우에는 함수를 그대로 사용해도 구현할 수 있다.
- 더 복잡한 조건으로 정렬을 하기 위해서는 사용자 정렬을 해야 한다.
2. 정렬 알고리즘 종류
- 시간 복잡도
선택 정렬,삽입 정렬,버블 정렬
- 시간 복잡도
병합 정렬,퀵 정렬
3. 파이썬에서 정렬 함수
-
파이썬에서
sorted()함수 설명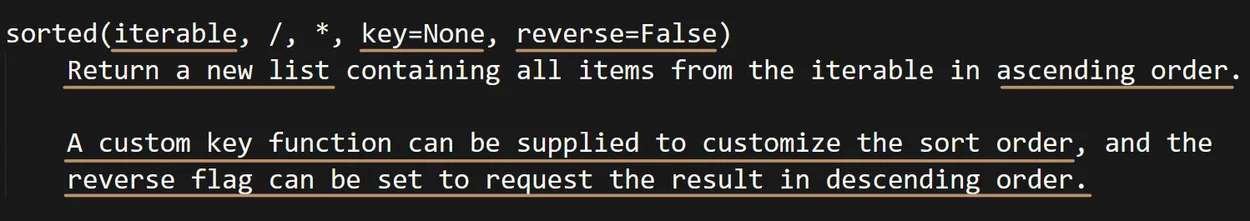
- 기본적으로, 입력으로 주어진 배열에 대해 오름차순 정렬하여 새로운 리스트로 반환함.
`iterable`: 리스트와 같이 순회할 수 있는 객체를 의미
# 리스트
lst = [3, 4, 5, 2, 1]
print(lst)
# print(list(lst))
print(sorted(lst))
print(type(sorted(lst)))
print()


# 튜플
tp = (3, 4, 5, 2, 1)
print(tp)
# print(list(tp))
print(sorted(tp))
print(type(sorted(tp)))
print()


# 딕셔너리 (키들을 정렬)
dt = {'d': 1, 'a': 2, 'c': 3}
print(dt)
# print(list(dt))
print(sorted(dt))
print(type(sorted(dt)))
print()


# 문자열
s = "cbfABVeda31"
print(s)
# print(list(s))
print(sorted(s))
print(type(sorted(s)))
print()- 리스트로 형 변환할 수 있는 객체면
sorted()함수를 사용할 수 있다고 생각해도 된다.
- `key`: 적절한 함수를 넣으면 사용자 정렬이 가능함.
- `reverse`: 이 옵션을 True로 하면 결과를 역순으로 반환함.-
예제 문제1) 숫자 정렬
개의 숫자가 주어질 때, 숫자들을 오름차순으로 정렬한 결과와 내림차순으로 정렬한 결과를 출력하시오.
-
입력
-1 3 0 7 0 10 -3 7 1 8 -
출력
-3 -1 0 0 1 3 7 7 8 10
10 8 7 7 3 1 0 0 -1 -3
`정답 코드`
arr = list(map(int, input().split()))

arr1 = sorted(arr)
arr2 = sorted(arr, reverse=True)

print(' '.join(map(str, arr1)))
print(' '.join(map(str, arr2)))-
예제 문제2) 문자열 정렬
개의 단어들이 주어질 때, 단어들을 사전순으로 정렬한 결과 출력하시오.
입력으로는 이 먼저 주어지며, 이어서 단어들이 줄 단위로 주어진다.
-
입력
7 banana orange blueberry pineapple apple mango strawberry -
출력
apple banana blueberry mango orange pineapple strawberry -
최악의 시간 복잡도: $20 * (100,000 * log_2100,000)$ = 34,000,000(삼천사백만회) ≤ 1억
`정답 코드`
N = int(input())
words = [input() for _ in range(N)]

words = sorted(words)

for word in words:
	print(word)
4. 파이썬에서 사용자 정렬
- 배열에 들어 있는 원소가 여러 값을 담고 있는 경우의 정렬
- 인덱스가 낮은 값을 기준으로 정렬을 진행 ⭐
- 이때도, 기본적으로 오름차순을 기준으로 정렬 ⭐
예시 코드
arr1 = [4, 2, 3, 1, 5]
print(sorted(arr1))
print()

arr2 = [(2, 3), (2, 1), (1, 3), (1, -1), (3, 2)]
print(sorted(arr2))
print()

arr3 = [(2, 1, 1), (1, 1, 3), (1, 2, 1), (1, 1, 2)]
print(sorted(arr3))
print()sorted()함수의key옵션key옵션에는 정렬의 기준이 되는 함수가 들어간다.key옵션의 기본값은lambda x: x라고 생각할 수 있다.
`예시 코드1`
def comp(x):
	return x

arr1 = [4, 2, 3, 1, 5]
print(sorted(arr1))
print(sorted(arr1, key=comp))
print()

arr2 = [(2, 3), (2, 1), (1, 3), (1, -1), (3, 2)]
print(sorted(arr2))
print(sorted(arr2, key=comp))
print()

arr3 = [(2, 1, 1), (1, 1, 3), (1, 2, 1), (1, 1, 2)]
print(sorted(arr3))
print(sorted(arr3, key=comp))
print()
`예시 코드2`
def comp(x):
	return x

arr1 = [4, 2, 3, 1, 5]
print(sorted(arr1))
print(sorted(arr1, key=comp))
print(sorted(arr1, key=lambda x : x))
print()

arr2 = [(2, 3), (2, 1), (1, 3), (1, -1), (3, 2)]
print(sorted(arr2))
print(sorted(arr2, key=comp))
print(sorted(arr2, key=lambda x : x))
print()

arr3 = [(2, 1, 1), (1, 1, 3), (1, 2, 1), (1, 1, 2)]
print(sorted(arr3))
print(sorted(arr3, key=comp))
print(sorted(arr3, key=lambda x : x))
print()
`예시 코드3`
arr1 = [4, 2, 3, 1, 5]
print(sorted(arr1))
print(sorted(arr1, key=lambda x : x))
# print(sorted(arr1, key=lambda x : -x))
print()

arr2 = [(2, 3), (2, 1), (1, 3), (1, -1), (3, 2)]
print(sorted(arr2))
print(sorted(arr2, key=lambda x : x))
# print(sorted(arr2, key=lambda x : -x))
print()

arr3 = [(2, 1, 1), (1, 1, 3), (1, 2, 1), (1, 1, 2)]
print(sorted(arr3))
print(sorted(arr3, key=lambda x : x))
# print(sorted(arr3, key=lambda x : -x))
print()- 사용자 정렬하기
key옵션을 이용해서 원소의 어떤 값을 기준으로 정렬할 것인지를 설정할 수 있다.key옵션에는 함수가 들어간다.
ex1) 원소를 내림차순 정렬
lst = [3, 4, 1, 2]
result = sorted(lst, key=lambda x: -x)
print(result)
ex2) 인덱스 1인 값을 기준으로 내림차순, 만약 인덱스 1인 값이 같다면, 인덱스 0인 값을 기준으로 오름차순 정렬
lst = [(3, 10), (4, 20), (1, 30), (2, 20)]
result = sorted(lst, key=lambda x: (-x[1], x[0]))
print(result)
(4, 20)과(2, 20)을 비교하는 과정lambda x: (-x[1], x[0])에 두 원소를 대입하면 결과는 다음과 같다.(4, 20)→(-20, 4)(2, 20)→(-20, 2)
- 이렇게
key함수를 통해 나온 결과를 기준으로 정렬하게 된다. - 따라서, 정렬 결과는
(2, 20)이(4, 20)보다 앞에 위치하게 되는 것이다.
알아두면 좋은 내용들
정렬 관련 내용 정리
- 파이썬에서 정렬은 기본적으로 오름차순이다!
- 문자열의 오름차순 정렬은 사전순(아스키코드가 낮은 순)이다!
- 배열의 원소가
(3, 4, 5)처럼 여러 개의 값이 들어 있다면, 앞에 있는 원소를 우선적으로 비교한다. - 파이썬에서의 사용자 정렬은 key 옵션을 통해서 가능하며, 함수 형태로 어떤 값을 기준으로 정렬할 것인지 지정해 주면 된다.
파이썬의 **람다(lambda) 함수**에 대하여
- 람다(lambda) 함수는 한 줄 함수이며 매개변수와 반환할 값을 쓰면 된다.
lambda arguments: expressionarguments: 함수의 매개변수expression: 함수의 반환값
예시 코드
def func1(x, y):
	return x + y

func2 = lambda x, y: x + y

print(func1(3, 4))
print(func2(3, 4))- 람다(lambda) 함수는 언제 쓰이는가?
- 람다(lambda) 함수는 선언과 동시에 사용할 수 있으므로, 간단한 함수를 인자로 넘겨줄 때 자주 사용한다.