Redis 장애 시 RDBMS의 연쇄적인 장애에 대응하기 위한 전략
들어가며
부트캠프 프로젝트에서 게시글 조회 API의 조회수 증가로 인해 RDBMS에 반복적인 쓰기 요청이 발생하는 문제가 있었다.
이를 개선하기 위해 Redis에 조회수 증가분을 먼저 기록하고, 이후 비동기적으로 RDBMS에 반영하는 방식으로 변경했다.
그런데 여기서 한 가지 문제가 생겼다.
Redis에 장애가 발생하면 어떻게 해야 할까?
가장 간단하게 생각하면 Redis 장애 시 RDBMS에 직접 쓰도록 Fallback을 구성할 수 있다.
하지만 갑자기 많은 요청이 RDBMS로 몰린다면 Redis 장애가 RDBMS의 부하로 이어지고, 결국 연쇄적인 장애로 이어질 수도 있다.
따라서 오늘은 Redis 자체의 가용성을 높이는 방법을 알아보기로 했다.
Redis가 1개일 경우 발생하는 문제
흔히 생각할 수 있는 방법은 Redis가 하나만 존재하는 구조에서 벗어나는 것이다.
Redis에 장애가 발생하면 애플리케이션에서도 Redis를 사용할 수 없게 된다.
그렇다면 Redis를 여러 개 띄우면 어떨까?
한 Redis에 장애가 발생하면 다른 Redis를 사용할 수 있을 것 같다.
Redis에서는 이러한 고가용성을 구성하기 위한 방법으로 Sentinel과 Cluster를 제공한다.
Sentinel
Redis Sentinel은 기본적으로 Master 1개 + Replica 여러 개 구조에서 Redis의 장애를 감시하고, Master 장애가 발생하면 Replica를 새로운 Master로 승격시키는 역할을 한다.
가장 간단한 구조
먼저 Sentinel을 제외하고 Master와 Replica만 생각해보자.
평상시에는 애플리케이션이 Master에 쓰기 요청을 보낸다.
이때 Master에 저장된 데이터는 Redis의 replication을 통해 Replica에도 복제된다.
따라서 Master와 Replica가 동일한 데이터를 가지고 있는 상태가 된다.
그런데 Master가 죽으면?
Master가 중간에 죽으면 문제가 발생한다.
Replica는 살아있지만, 애플리케이션은 여전히 기존 Master의 주소로 요청을 보내려고 한다.
Replica가 살아있다고 해서 자동으로 Master가 되는 것도 아니다.
이 문제를 해결하기 위해 Sentinel이 등장한다.
Sentinel은 영어로 ‘초병’, ‘파수꾼’ 이라는 뜻을 가진다고 한다.
(개념을 학습하니 이 이름을 가진 것이 이해가 됐다.)
Sentinel을 추가하면
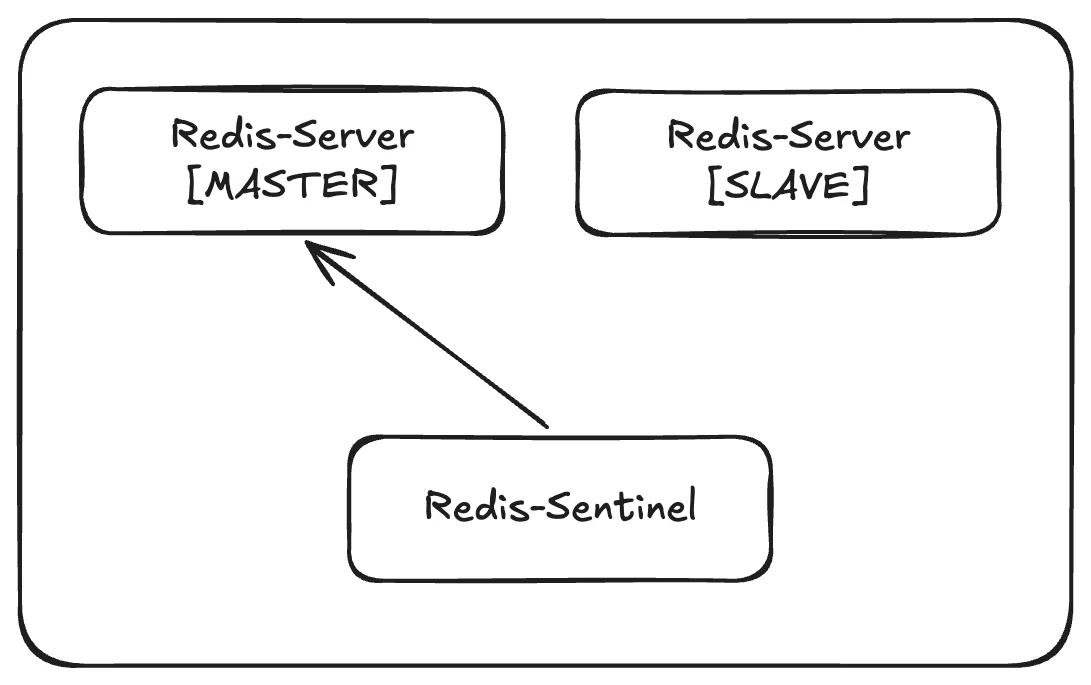
Sentinel은 Redis Master와 Replica의 상태를 감시한다.
Master가 정상적으로 동작하고 있다면 특별한 작업을 하지 않는다.
하지만 Master가 장애를 일으키면 Sentinel이 이를 감지하고 Replica를 새로운 Master로 승격시킨다.
이렇게 하면 Redis Master 한 대에 장애가 발생하더라도 서비스를 계속 유지할 수 있다.
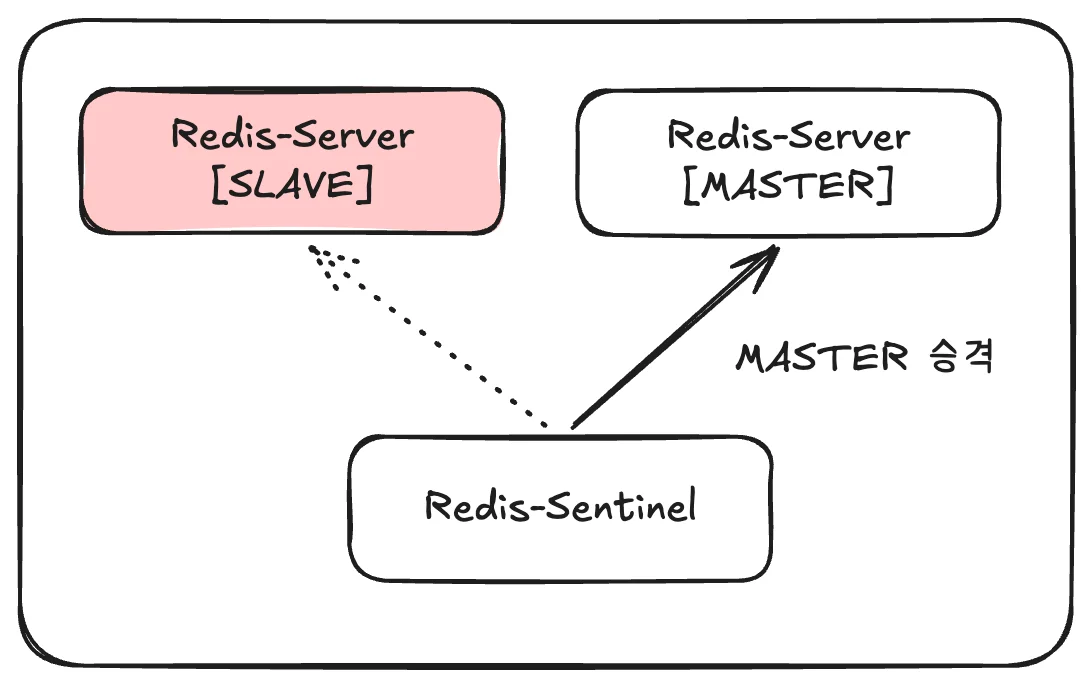
다만, 여기서 주의할 점은 Redis-Master, Redis-Slave, Redis-Sentinel을 한 곳에 모아두면 위험하다.
혹여나 한 곳에 모아뒀다가 인스턴스 자체에 장애가 난다면? 이렇게 분산해둔 의미가 없다.
계란을 한 바구니에 담지 말라
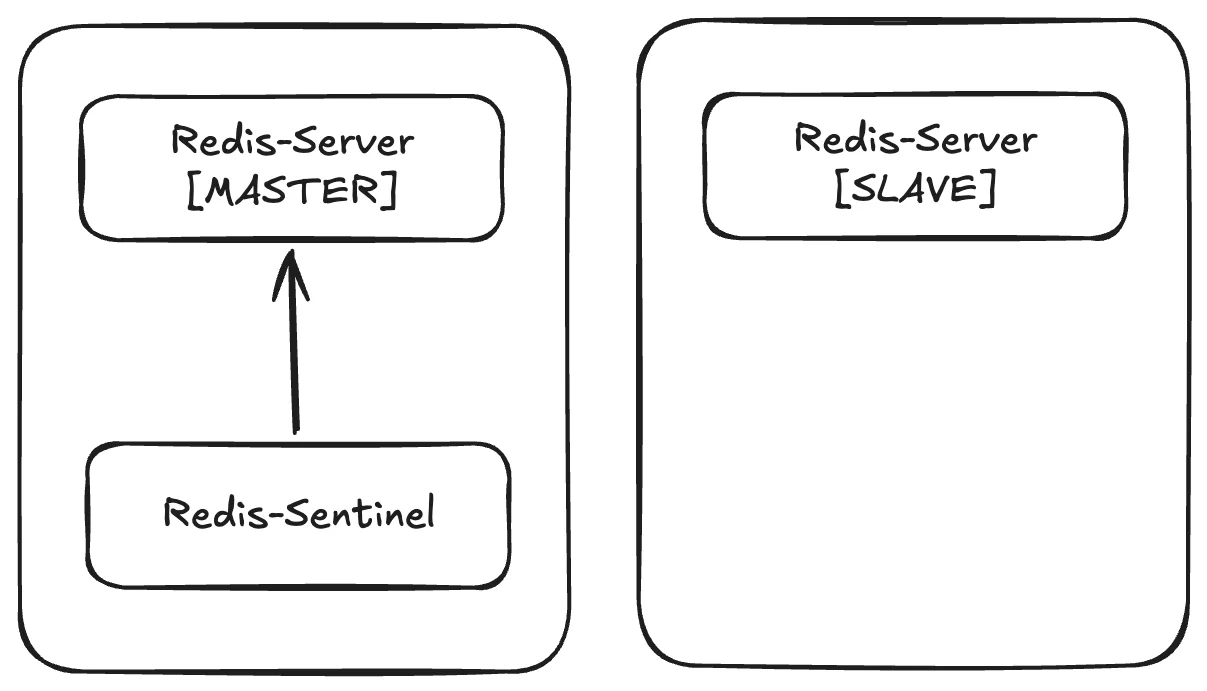
따라서, Redis-Master와 Redis-Slave 를 각각 다른 인스턴스에 저장하는 것을 고려해볼 수 있다.
다만, 위 구조에서도 Redis-Sentinel가 한 개이기 때문에 Sentinel 자체에 장애가 난다면 문제가 생길 수 있다.
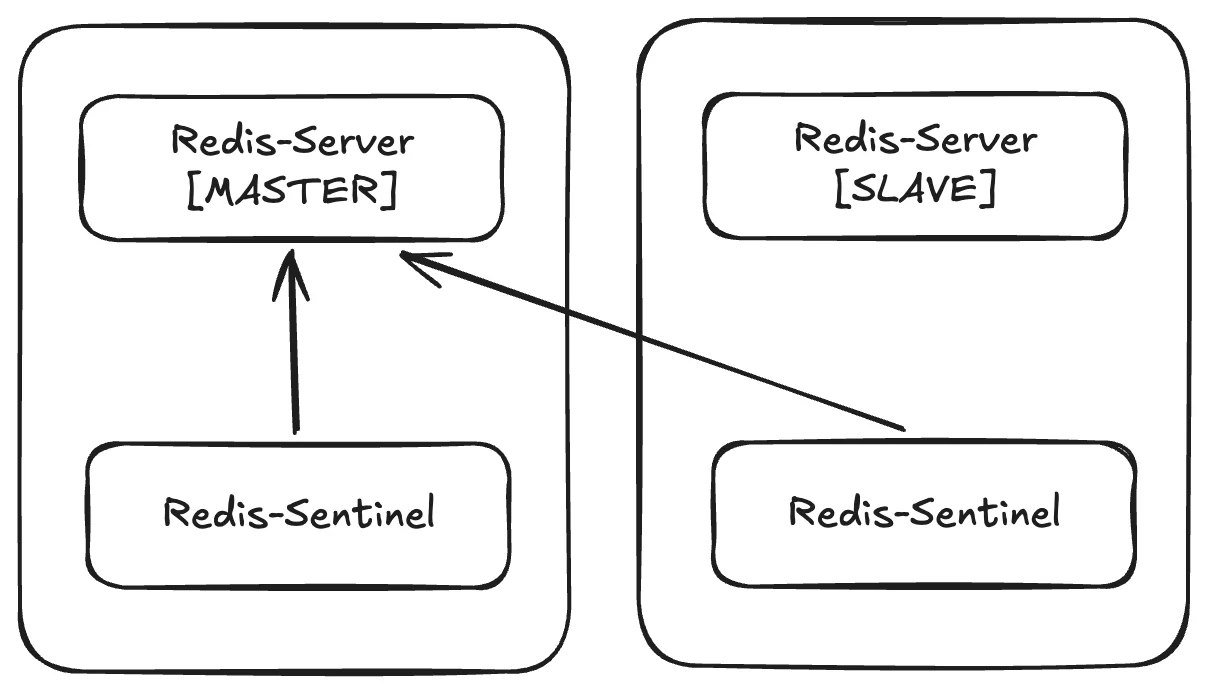
그렇다면 Redis-Sentinel 도 각각의 인스턴스에 만들어서 2개를 두는 방법은 어떨까?
이렇게 하면 가용성이 다 확보된게 아닐까?… 라고 생각했지만 끝이 아니었다.
Split Brain 문제
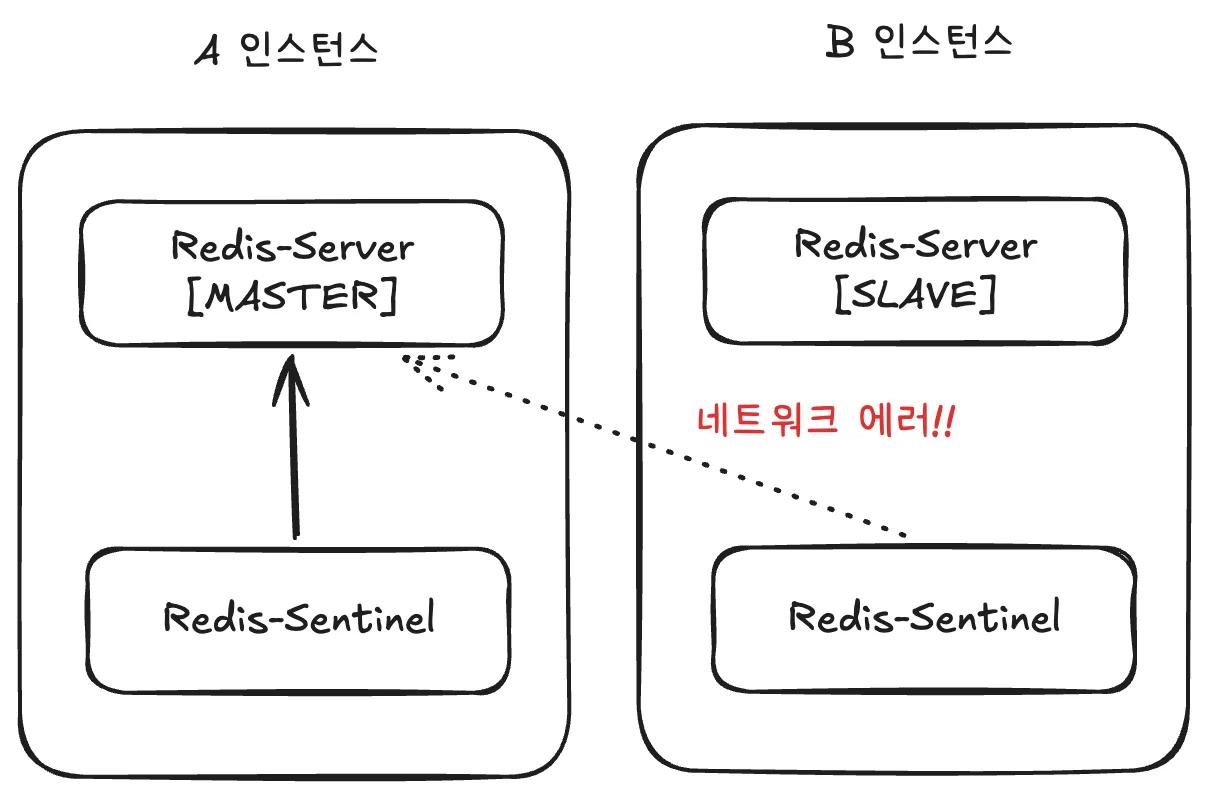
그림에서 왼쪽이 A 인스턴스, 오른쪽이 B 인스턴스라고 했을 때
A가 실제로 죽은 게 아니라 네트워크가 잠깐 끊긴 상황을 생각해보자.
B 인스턴스의 Sentinel 입장에서는 “엥 뭐임? A 왜 응답 없음?” 이라고 생각하게 되는데
실제로는 A는 살아 있는데 B와 통신만 안 되는 상황일 수 있다.
그런데 이때 B가 “A가 죽었다!” 라고 판단해서 B Replica를 Master로 승격시켜버린다면?
A는 A가 Master라고 생각하고, B는 B가 Master라고 생각하는 문제가 발생할 수 있다.
이러한 현상은 Split Brain 이라고 한다.
두 Redis가 서로 Master라고 생각하면서 각각 데이터를 받으면 데이터가 갈라지는 문제가 발생한다.
그래서 Sentinel을 여러 개 둔다
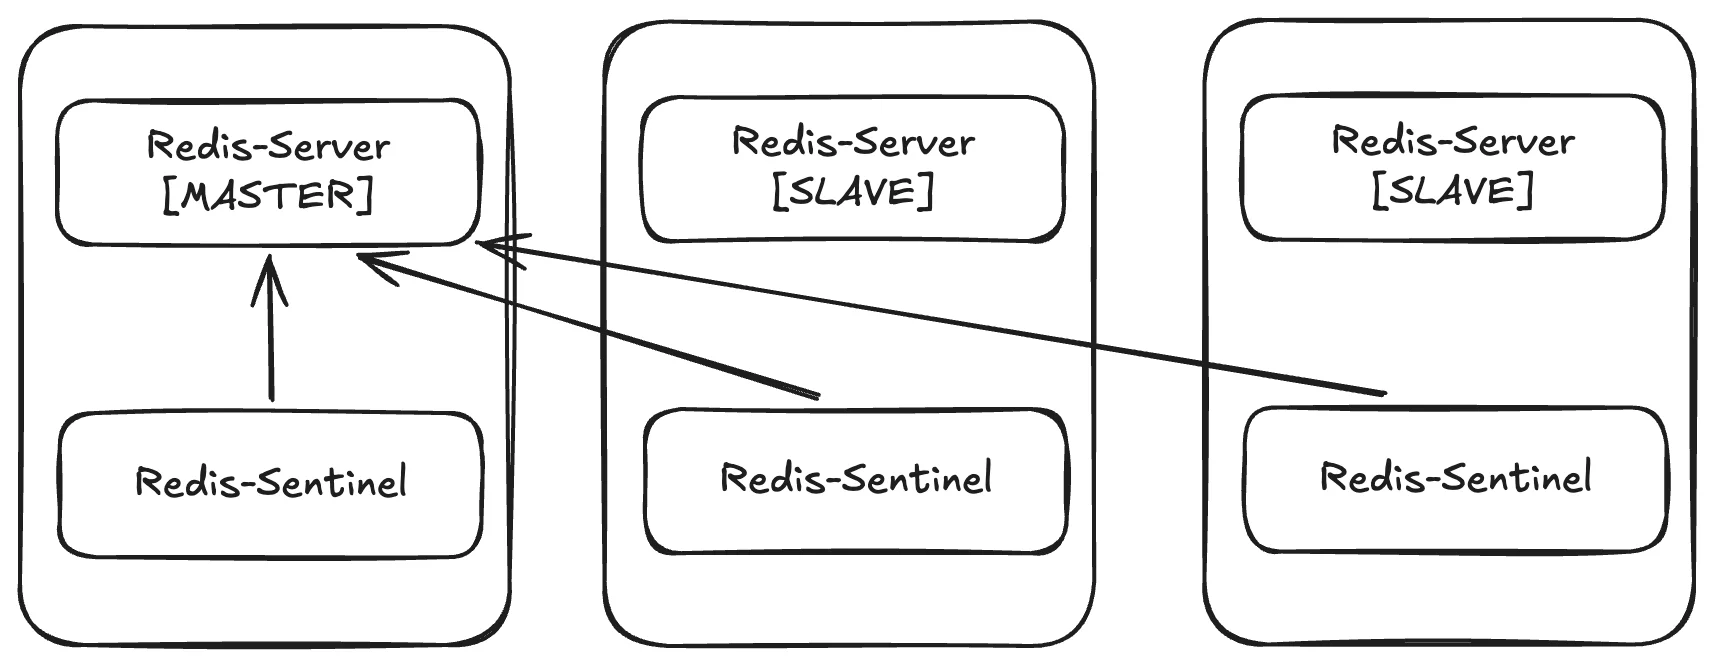
이 문제를 해결하기 위해서 Sentinel을 2개보다 더 많이 두는 결정을 한다고 한다.
예를 들어, Sentinel이 3개라고 가정하고 다시 위 문제를 살펴보자.
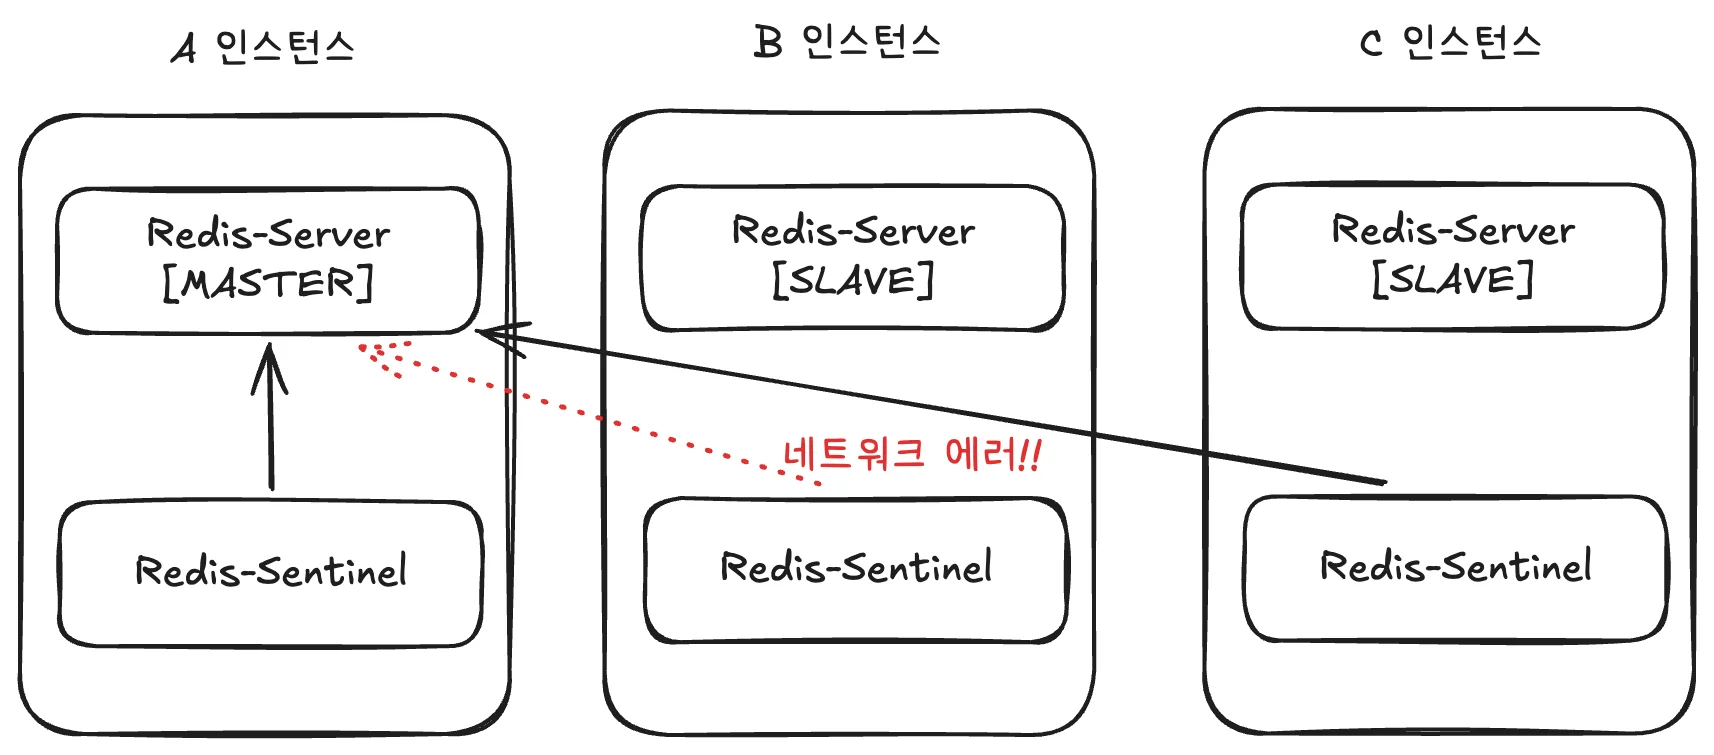
A와 B 사이의 네트워크가 끊겼다. 이때 B 인스턴스 Sentinel은 A가 응답하지 않으니 장애라고 판단했다.
하지만 C 인스턴스의 Sentinel은 A와 정상적으로 통신하고 있다면 “A 정상인데?” 라고 판단할 수 있다.
이때 Sentinel들을 의회의 의원이라고 생각하면 이해하기 쉽다.
- B Sentinel → “A 장애입니다!”
- C Sentinel → “A 정상인데요?”
- A Sentinel → “저는 A에 있으니 일단 살아있습니다!”
한 명의 의원이 “잘못되었습니다!” 라고 주장한다고 해서 바로 국가의 중요한 결정을 내리지는 않는다.
여러 의원이 같은 사실을 확인하고, 정해진 수 이상의 의원이 동의했을 때 의사결정을 진행한다.
즉, Sentinel 하나의 판단만으로 Master를 바꾸는 것이 아니라 여러 Sentinel의 판단을 모아서 의결정족수(quorum)를 만족했을 때 Failover를 진행한다.
여기서 Sentinel의 quorum을 쉽게 생각하면 “어느 정도 숫자의 의원이 동의해야 장애라고 인정할 것인가?”에 가깝다.
그래서 Sentinel을 3개 구성하면 2개가 동의해야 하는 식으로 구성할 수 있고, 하나의 Sentinel이 잘못 판단하더라도 나머지 Sentinel들이 이를 보완할 수 있다.
그럼 애플리케이션은 어떻게 새로운 Master를 알 수 있을까?
여기서 Sentinel의 또 다른 역할이 등장한다.
단순히 Replica를 Master로 승격시키는 것뿐만 아니라, 현재 Master가 누구인지 클라이언트가 알아낼 수 있도록 해준다.
💡 Redis Client란?
Redis Client는 애플리케이션이 Redis Server와 통신할 수 있도록 해주는 라이브러리다.
예를 들어 Node.js 진영에서는 ioredis, node-redis 등이 Redis Client 역할을 한다.
애플리케이션에서 redis.get(), redis.set() 등을 호출하면 Redis Client가 이를 Redis 명령으로 반환하여 Redis Server와 통신한다.
이때 애플리케이션의 Redis Client에는 각 인스턴스에 있는 Sentinel의 주소를 등록해둔다.
const redis = new Redis({
  sentinels: [
    { host: "instance-a", port: 26379 },
    { host: "instance-b", port: 26379 },
    { host: "instance-c", port: 26379 },
  ],
  name: "mymaster",
  failoverDetector: true,
  commandTimeout: 2000
});
여기서 중요한 점은 sentinels에 Redis Master나 Replica의 주소를 등록하는 것이 아니라 Sentinel의 주소를 등록한다는 것이다.
Redis Client는 등록된 Sentinel 중 하나에 접속해서 “mymaster라는 이름의 Master가 지금 어디에 있어?” 라고 물어본다.
예를 들어 Sentinel A가 “현재 Master는 인스턴스 A의 Redis야.” 라고 알려주면 Redis Client는 이후 Redis A와 직접 통신한다.
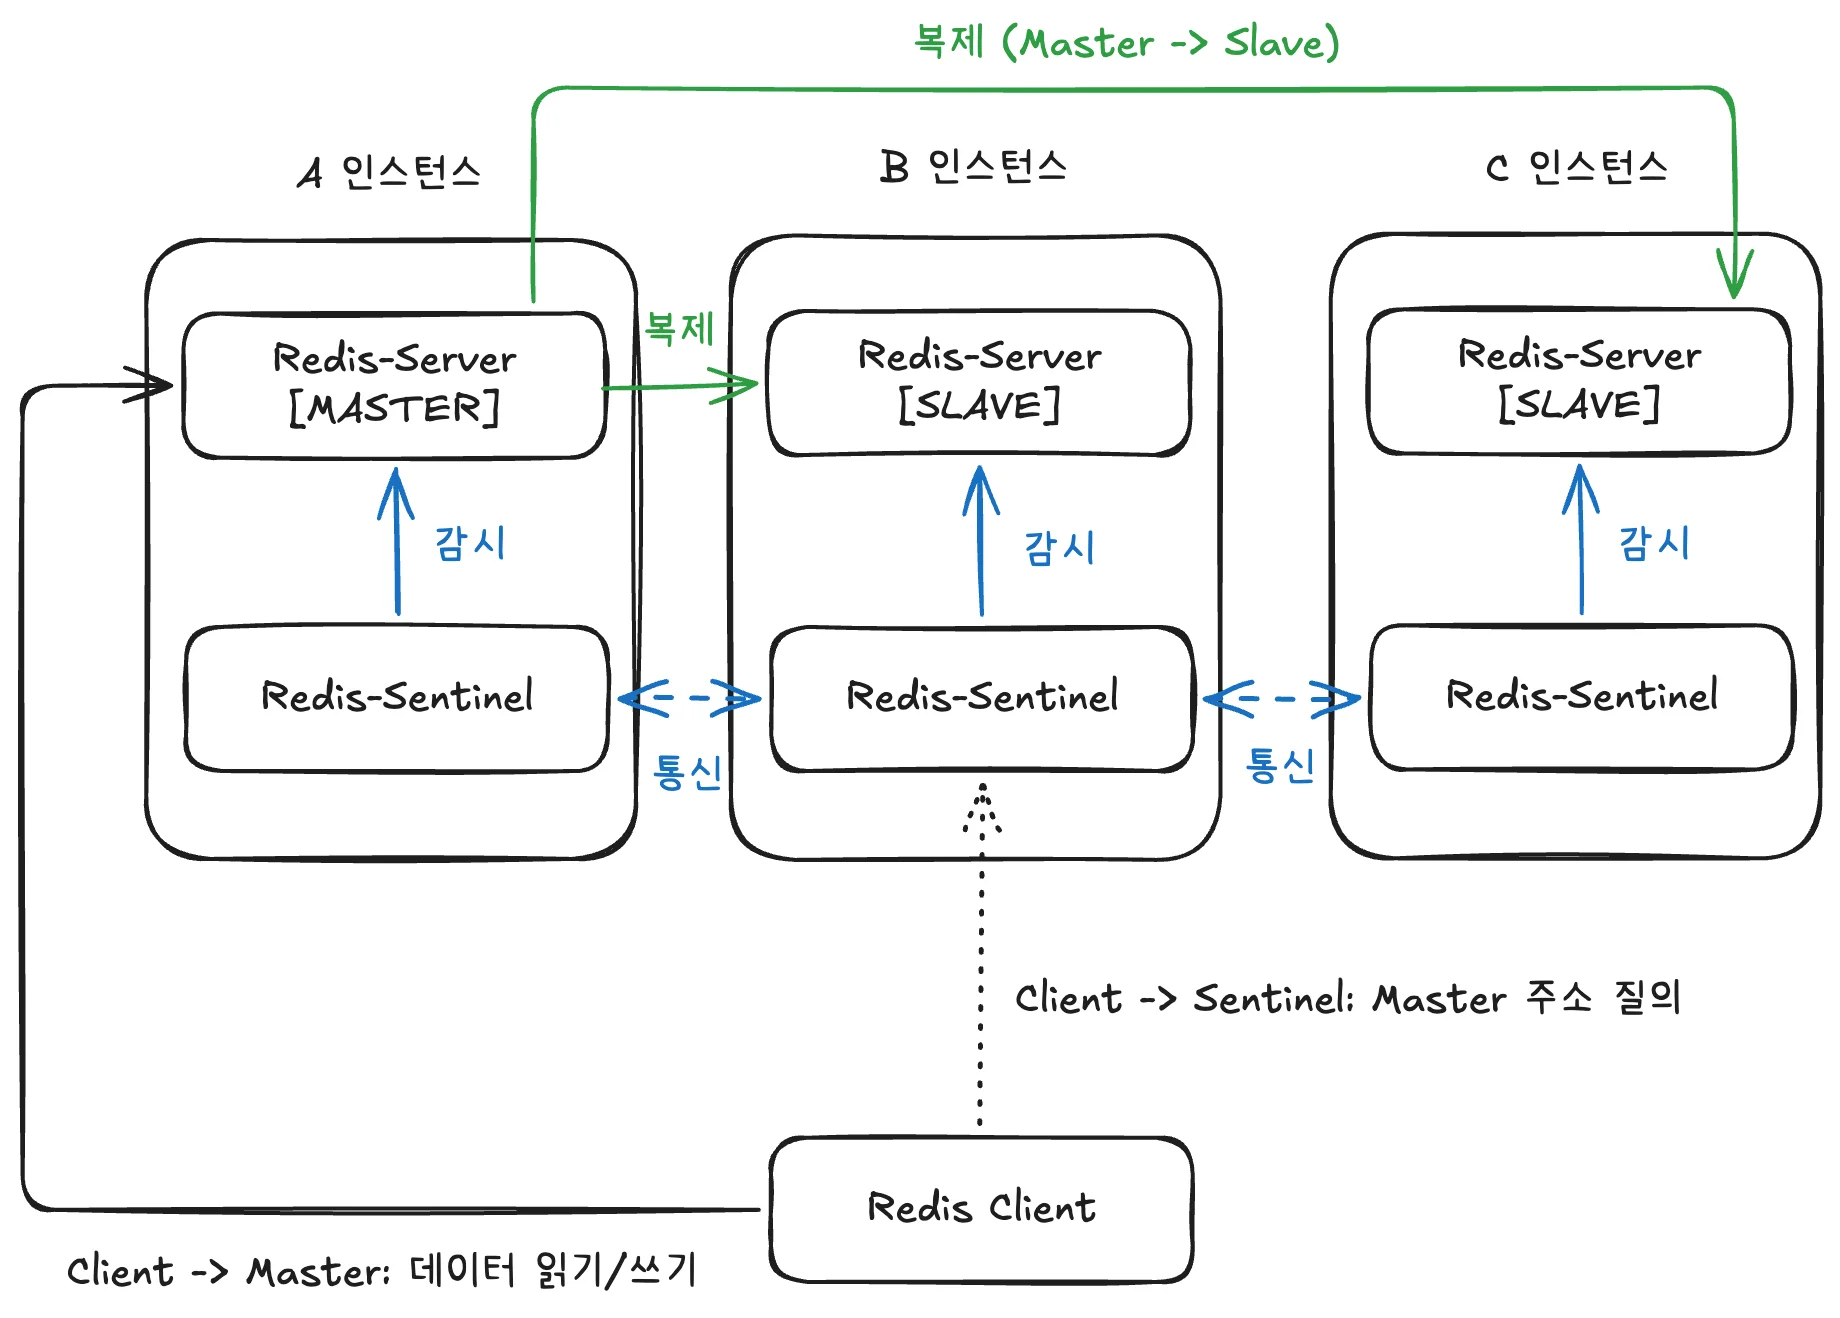
만약 Sentinel A가 응답하지 않는다면 Redis Client는 다른 Sentinel B나 C를 통해 현재 Master의 위치를 확인할 수 있다.
그리고 Master A에 장애가 발생하면 Sentinel들이 장애를 판단하고 Replica B를 새로운 Master로 승격시킨다.
각 서비스들은 어떻게 서로 통신할 수 있나?
여기까지 Sentinel의 역할을 이해해보았다.
그렇다면 한 가지 드는 궁금증은 Redis Sentinel, Redis Server들은 어떻게 서로의 존재를 알고 통신하는걸까?
결론부터 말하면 Sentinel은 Redis의 Pub/Sub을 이용해 서로의 존재와 상태 정보를 발견하고 공유한다.
💡 Redis Pub/Sub 이란?
Redis Pub/Sub(Publish/Subscribe)은 메시지를 특정 채널에 발행하고, 해당 채널을 구독한 클라이언트가 메시지를 전달받는 방식이다.
메시지를 보내는 쪽을 Publisher, 메시지를 받는 쪽을 Subscriber라고 한다.
Publisher는 Subscriber가 누구인지 알 필요가 없다. 단순히 특정 채널에 메시지를 발행하면 해당 채널을 구독하고 있는 모든 Subscriber에게 메시지가 전달된다.
단, Pub/Sub은 메시지를 저장하는 시스템이 아니다. Subscriber가 메시지를 받을 당시 연결되어 있지 않다면 해당 메시지를 나중에 다시 받을 수 없다.
Sentinel은 어떻게 서로를 발견할까?
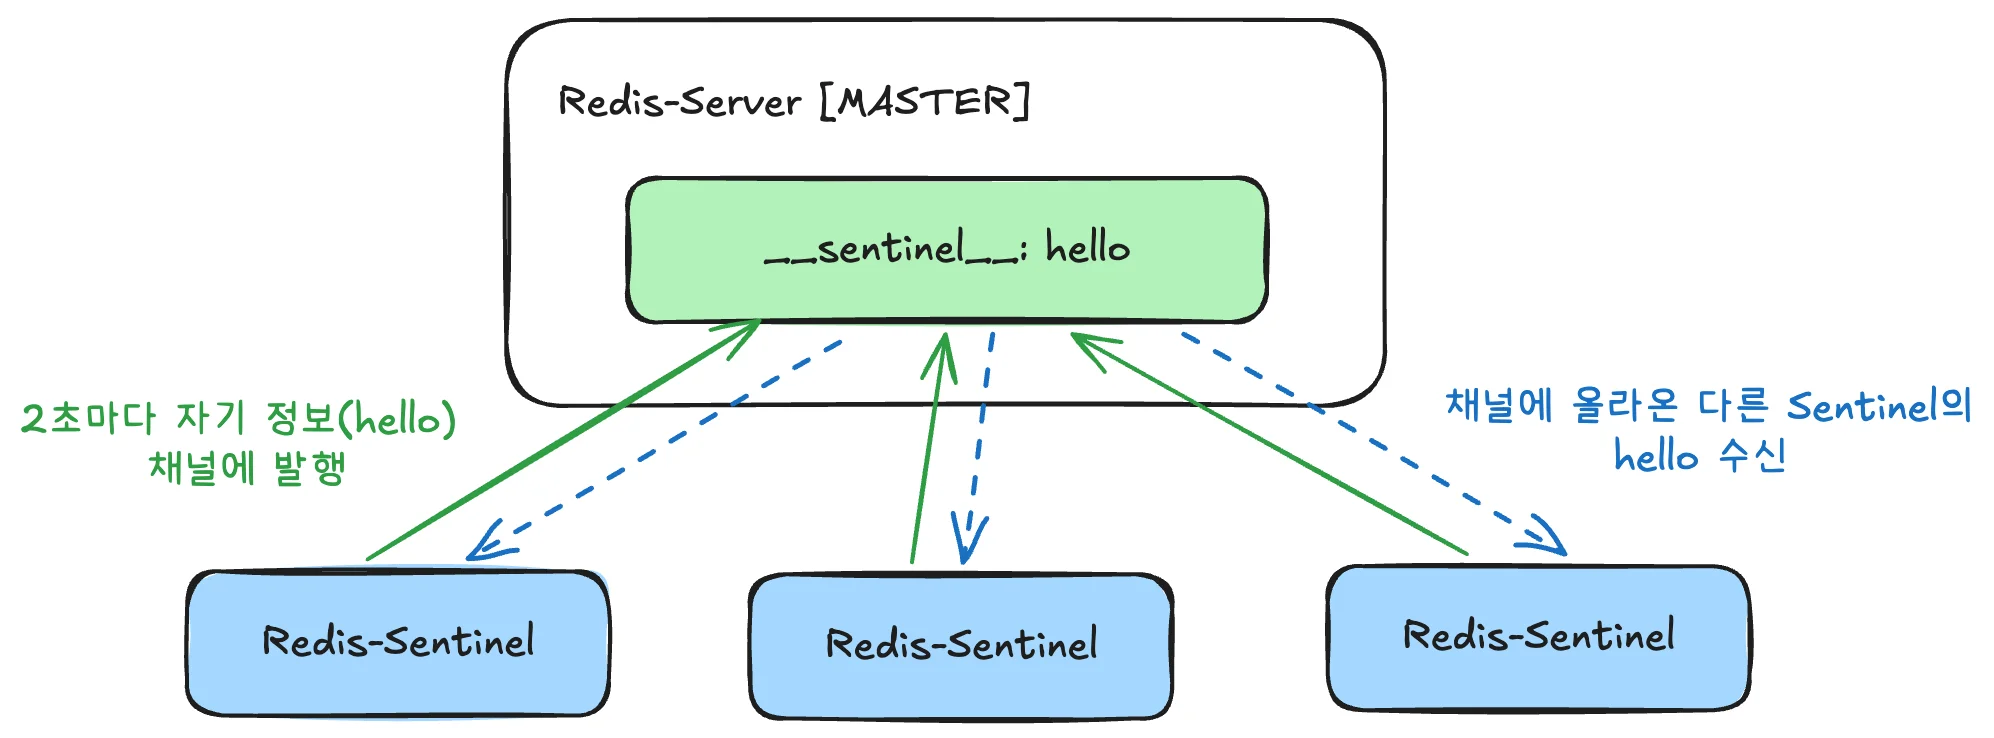
Sentinel은 자신이 감시하고 있는 Redis Master의 Pub/Sub 채널을 이용한다.
Sentinel이 Redis에 접속하면 __sentinel__:hello 라는 채널을 통해 자신의 정보를 알린다. (2초마다 발행)
쉽게 생각하면 Sentinel이 Redis에 다음과 같이 명함을 뿌리는 것이다.
“나는 Sentinel A야. 내 주소는 A:26379이고, mymaster라는 Redis Master를 감시하고 있어.”
다른 Sentinel들은 이 메시지를 통해 “아, 다른 Sentinel도 이 Master를 감시하고 있구나” 라고 알게 된다.
그리고 서로의 주소와 감시 대상 등의 정보를 알게 된 이후에는 Sentinel끼리 직접 통신하면서 상태 정보를 주고 받는다.
그렇다면 Redis Server 끼리는?
Redis Master는 처음부터 어떤 Master를 복제할지 설정되어 있다.
예를 들어 Replica에게
replicaof redis-master 6379와 같이 설정하면 Replica는 redis-master:6379 에 접속해서 데이터를 복제한다.
즉,
- Sentinel ↔ Sentinel → Pub/Sub을 이용해 서로 발견하고 이후 직접 통신
- Master ↔ Replica → Replica가 Master를 알고 직접 연결하여 복제
- Application ↔ Redis → Redis Client가 Redis Server에 직접 연결
Failover는 어떻게 진행될까?
이제 Sentinel들이 서로를 어떻게 발견하고 통신하는지 알아봤다.
그렇다면 실제로 Master에 장애가 발생했을 때 Sentinel은 어떤 과정을 거쳐 Failover를 수행할까?
전체적인 흐름은 다음과 같다.
- Master 장애 발생
- Sentinel들이 Master의 상태 확인
- 장애 여부에 대한 합의
- Failover를 수행할 Leader 선출
- Replica를 새로운 Master로 승격
- Client가 새로운 Master를 사용
1. Master의 장애를 감지한다
먼저 Sentinel은 주기적으로 Master에게 PING을 보내 정상적으로 응답하는지 확인한다.
만약 일정 시간 동안 Master가 응답하지 않는다면 해당 Sentinel은 “Master에 문제가 있는 것 같은데?” 라고 판단한다.
이 상태를 SDOWN(Subjectively Down) 이라고 한다.
2. 여러 Sentinel이 장애를 확인한다
Sentinel들은 서로 통신하면서 Master의 상태를 확인한다.
여러 Sentinel이 Master에 문제가 있다고 판단하고 설정된 quorum을 만족하면 Master를 실제 장애 상태로 판단한다.
이를 ODOWN(Objectively Down) 이라고 한다.
3. Failover를 수행할 Leader를 선출한다
Master의 장애가 확인됐다고 해서 모든 Sentinel이 동시에 Replica를 Master로 승격시키면 문제가 발생할 수 있다.
따라서 Sentinel들은 “그럼 누가 Failover를 진행할 것인가?” 를 결정해야 한다.
이때 Leader Election(리더 선출) 이 이루어진다.
Leader로 선출된 Sentinel이 Failover를 진행하고, 다른 Sentinel들은 이를 지원하고 상태를 공유한다.
4. Replica를 새로운 Master로 승격한다
Leader로 선출된 Sentinel은 기존 Replica 중 하나를 선택해서 새로운 Master로 승격시킨다.
Failover가 완료되면 Sentinel은 새로운 Master 정보를 반영하고, +switch-master 이벤트를 발생시켜 Master가 변경되었음을 알린다.
5. Client는 새로운 Master를 사용한다
이제 Sentinel들은 현재 Master가 누구인지에 대한 정보를 갱신한 상태이다.
Redis Client가 Sentinel에게 현재 Master의 주소를 요청하면 새로운 Master 주소를 받을 수 있다.
실습
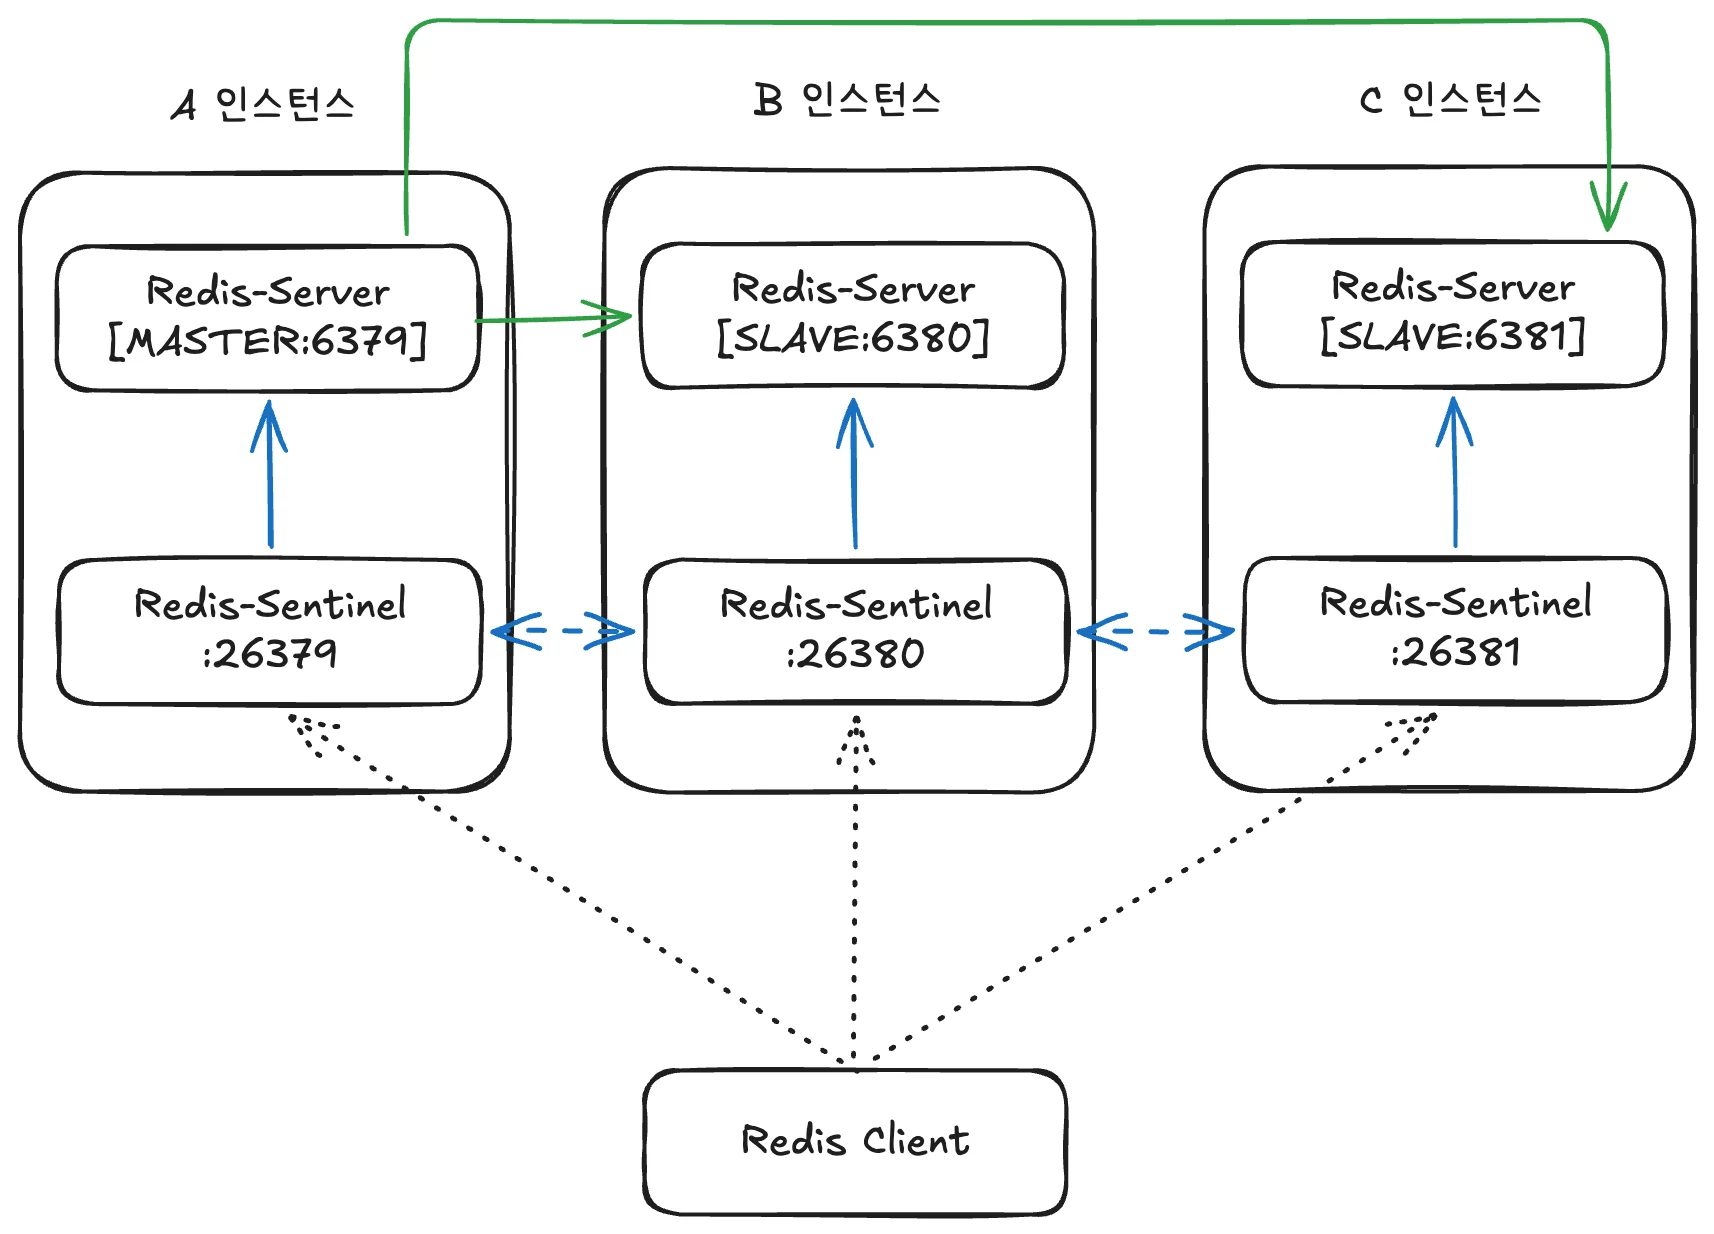
이번엔 Node.js 와 Redis를 통해 고가용성 환경을 직접 구현해보자.
위의 아키텍처대로 구성을 하기에는 가상머신을 띄워서 해야하므로 번거로우니 컨테이너 하나 = 인스턴스 하나 로 취급하고 Docker Compose로 한 번에 띄운다. (테스트 하기에는 충분한다.)
실습을 통해 위에서 정리한 개념들을 직접 확인해보자.
- 복제
- 감시
- SDOWN/ODOWN
- quorum
- 리더 선출
- failover
- Split Brain
구성
- 인스턴스 A, B, C 세 곳에 각각 Redis 1개 + Sentinel 1개를 둔다.
- A의 Redis가 처음 Master, B와 C는 Replica다.
- Sentinel은 3개, quorum은 2다.
- Node.js 앱은 Redis 주소가 아니라 Sentinel 주소만 알고 있다.
최종 디렉터리 구조
redis-sentinel-practice/
├── docker-compose.yml
├── sentinel/
│   ├── sentinel-a.conf
│   ├── sentinel-b.conf
│   └── sentinel-c.conf
└── app/
    ├── package.json
    └── index.js
이제 단계별로 만들어보자.
Step 1. Redis Master + Replica 만들기
가장 먼저 Sentinel 없이 Master 1개 + Replica 2개 복제 구조부터 만든다.
services:
  redis-a:
    image: redis:7
    container_name: redis-a
    command: redis-server --appendonly yes
    ports:
      - "6379:6379"

  redis-b:
    image: redis:7
    container_name: redis-b
    command: redis-server --appendonly yes --replicaof redis-a 6379
    depends_on:
      - redis-a
    ports:
      - "6380:6379"

  redis-c:
    image: redis:7
    container_name: redis-c
    command: redis-server --appendonly yes --replicaof redis-a 6379
    depends_on:
      - redis-a
    ports:
      - "6381:6379"
왜 이렇게 했나
| 설정 | 이유 |
|---|---|
--replicaof redis-a 6379 | 글에서 말한 “Replica는 처음부터 어떤 Master를 복제할지 설정되어 있다” 가 이것이다. Replica가 redis-a:6379에 직접 접속해서 데이터를 복제한다. Sentinel이 복제를 시켜주는 게 아니다. |
redis-a (호스트 이름) | Compose가 만든 네트워크 안에서는 컨테이너 이름이 DNS 이름이 된다. IP는 재시작하면 바뀔 수 있으니 이름으로 접근한다. |
--appendonly yes | AOF를 켜서 컨테이너가 재시작되어도 데이터를 복구할 수 있게 한다. (이 실습에서 필수는 아니다) |
포트 6379/6380/6381 | 컨테이너 내부 포트는 모두 6379로 같다. 호스트(내 맥)에서 redis-cli로 접근할 수 있도록 호스트 쪽 포트만 다르게 매핑했다. |
depends_on | Master가 먼저 뜨도록 순서를 준다. (단, “준비 완료”까지 기다려주진 않는다. Replica는 연결에 실패하면 알아서 재시도한다.) |
확인
docker compose up -d
docker exec redis-a redis-cli info replication
위 명령어를 통해 redis-a 의 역할이 master고, slave 개수가 2개인 것을 확인할 수 있다.
role:master
connected_slaves:2
데이터가 복제되는지도 확인해보자.
docker exec redis-a redis-cli set hello world
docker exec redis-b redis-cli get hello     # "world"
이 상태에서 redis-a의 장애가 났다는 것을 가정하고, redis-a를 종료시킨다.
2026-10-09 14:42:46 1:S 09 Oct 2026 05:42:46.781 * Connection with master lost.
2026-10-09 14:42:46 1:S 09 Oct 2026 05:42:46.782 * Caching the disconnected master state.
2026-10-09 14:42:46 1:S 09 Oct 2026 05:42:46.782 * Reconnecting to MASTER redis-a:6379
2026-10-09 14:42:46 1:S 09 Oct 2026 05:42:46.784 * MASTER <-> REPLICA sync started
2026-10-09 14:42:46 1:S 09 Oct 2026 05:42:46.784 # Error condition on socket for SYNC: Connection refused
2026-10-09 14:42:47 1:S 09 Oct 2026 05:42:47.078 * Connecting to MASTER redis-a:6379
2026-10-09 14:42:47 1:S 09 Oct 2026 05:42:47.112 # Unable to connect to MASTER: Operation now in progress
2026-10-09 14:42:48 1:S 09 Oct 2026 05:42:48.135 * Connecting to MASTER redis-a:6379
2026-10-09 14:42:48 1:S 09 Oct 2026 05:42:48.142 # Unable to connect to MASTER: Operation now in progress
그러자 redis-b와 redis-c에서 위와 같이 난리부르스를 치는 것을 확인할 수 있다.
Replica는 살아있지만 스스로 Master가 되지는 못한다. 이 문제를 풀기 위해 Sentinel을 도입해보자.
Step 2. Sentinel 추가하기
Sentinel도 결국 redis-server 바이너리다. --sentinel 옵션을 주면 Sentinel 모드로 동작한다.
그래서 같은 redis:7 이미지를 사용한다.
sentinel-a:
  image: redis:7
  container_name: sentinel-a
  command: redis-server /etc/redis/sentinel.conf --sentinel
  volumes:
    - ./sentinel/sentinel-a.conf:/etc/redis/sentinel.conf
  depends_on:
    - redis-a
  ports:
    - "26379:26379"
Sentinel 설정 파일은 이렇게 시작할 수 있다.
port 26379
sentinel monitor mymaster redis-a 6379 2
핵심은 한 줄이다. 각 항목의 의미부터 정리하자.
sentinel monitor <이름> <master 호스트> <master 포트> <quorum>
sentinel monitor mymaster redis-a 6379 2| 항목 | 의미 |
|---|---|
mymaster | Master에 붙이는 논리적 이름. 앱(예: ioredis)이 Sentinel에게 “mymaster 어디 있어?”라고 물어볼 때 쓰는 이름이다. 실제 호스트가 바뀌어도(failover) 이름은 유지된다. |
redis-a 6379 | 최초 Master 주소. Sentinel은 이 Master에게 INFO를 보내 Replica 목록을 알아낸다. 그래서 Replica 주소는 적지 않는다. |
2 | quorum. 몇 개의 Sentinel이 “Master 죽었다”에 동의해야 ODOWN으로 볼 것인가. |
왜 Sentinel 설정에 다른 Sentinel 주소가 없을까
설정 파일에는 Master 주소만 있고 다른 Sentinel 주소는 없다. 그런데도 서로를 안다.
앞 글에서 본대로 Sentinel은 Master의 Pub/Sub 채널 __sentinel__:hello 로 서로를 발견하기 때문이다.
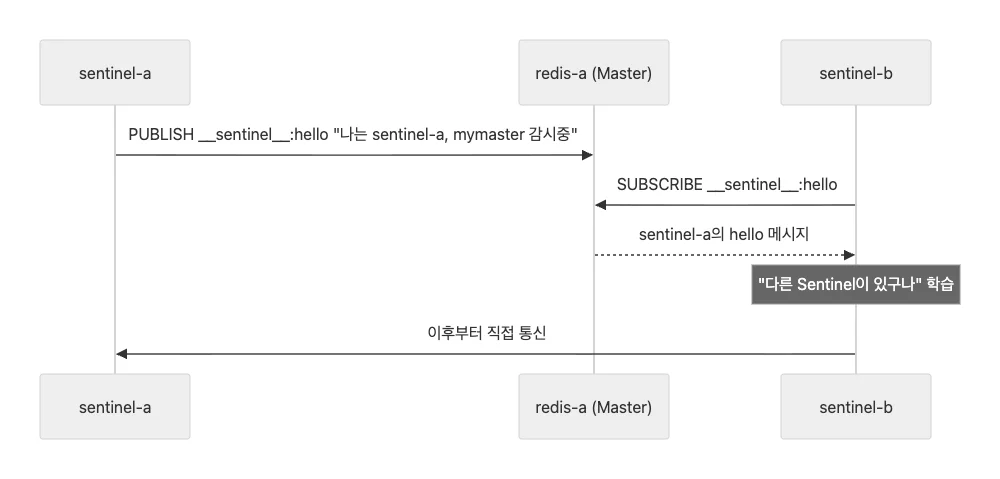
Step 3. 트러블 슈팅 ㅡ 컨테이너 IP 문제 (announce-*)
Sentinel은 서로를 발견하면 “내 주소는 이거야”를 알려준다. 기본값은 자신 IP다.
그런데 Docker 컨테이너의 IP는 재시작할 때마다 바뀔 수 있다.
기억하기도 어렵고, 바뀌면 Sentinel끼리 서로를 못 찾을 수 있다.
그래서 Sentinel이 IP 대신 호스트이름으로 자신을 알리도록 설정한다.
sentinel resolve-hostnames yes
sentinel announce-hostnames yes
sentinel announce-ip sentinel-a| 설정 | 이유 |
|---|---|
resolve-hostnames yes | sentinel monitor mymaster redis-a ... 처럼 설정에 IP가 아닌 호스트 이름을 쓸 수 있게 한다. (기본값은 no라서, 이름을 쓰면 시작 시 에러가 난다.) |
announce-hostnames yes | 다른 Sentinel이나 클라이언트에게 자신/Master를 알릴 때 호스트 이름을 그대로 알린다. |
announce-ip sentinel-a | ”나를 sentinel-a 라고 불러줘.” 컨테이너 안에서 자기 IP를 추측하는 대신 명시한다. |
그래서 Sentinel 설정 파일을 3개로 나눠서 announce-ip 값을 다르게 설정했다.
아래는 sentinel-a.conf 설정 파일인데, announce-ip 값만 서로 다르고 나머지 설정은 동일하다.
port 26379

# 인스턴스 A의 Sentinel. 다른 Sentinel/클라이언트에게 자신을 이 이름으로 알린다.
sentinel resolve-hostnames yes
sentinel announce-hostnames yes
sentinel announce-ip sentinel-a

# <name> <host> <port> <quorum>  (Sentinel 3개 → quorum=2)
sentinel monitor mymaster redis-a 6379 2

# Failover 관련 설정
sentinel down-after-milliseconds mymaster 5000
sentinel failover-timeout mymaster 10000
sentinel parallel-syncs mymaster 1
맨 마지막 3개 설정들은 모두 failover를 얼마나 서두를 것인가에 관한 값이다.
down-after-milliseconds: Master가 몇 ms 동안 응답이 없으면 SDOWN(주관적 다운) 으로 볼 것인가.failover-timeout: Failover 한 번의 시도에 허용하는 최대 시간(ms). 이 안에 끝나지 않으면 해당 시도는 실패로 보고, 다시 시도할 수 있다.parallel-syncs: 새 Master가 정해진 뒤 Replica들이 동시에 몇 개씩 새 Master와 동기화할 것인가.- 동기화 중인 Replica는 읽기 요청에 응답하지 못할 수 있다.
- 1이면 한 번에 한 대씩 동기화하므로 나머지 Replica는 계속 읽기를 받을 수 있다.
- 숫자가 크면 failover 이후 정상화가 빨라지지만 그동안 읽기 가용성이 떨어진다.
Step 4. 막힌 지점 2 ㅡ Sentinel이 설정 파일을 직접 고쳐 쓴다
Sentinel은 실행 중 상태가 바뀌면(예: Replica 발견, Failover로 Master 변경 등) 그 결과를 설정 파일에 직접 저장한다고 한다. 재시작해도 최신 상태를 기억해야 하기 때문이다.
실제로 한참 돌린 뒤 conf를 보면 직접 쓰지 않은 줄이 생겨 있다.
sentinel known-sentinel mymaster sentinel-a 26379 68b49dbd97573b115279c9897bd8bbe46d534a7f
sentinel known-sentinel mymaster sentinel-b 26379 773435f12d94419a0998325733e5f9cc6426cfd2
sentinel known-replica mymaster 172.21.0.4 6379
sentinel known-replica mymaster 172.21.0.3 6379
그런데 Step 2에서처럼 호스트이 파일을 컨테이너에 그대로 마운트하면 문제가 생긴다.
- 읽기 전용(
:ro) 으로 마운트하면 → Sentinel이 쓰지 못해 시작 시 에러 - 쓰기 가능으로 마운트하면 → Sentinel이 내 소스 코드 폴더의 conf를 계속 수정해서 git diff가 지저분해짐
해결: 시작할 때 컨테이너 내부로 복사해서 쓴다
x-sentinel: &sentinel
  image: redis:7
command: sh -c "cp /etc/redis/sentinel.conf /data/sentinel.conf && exec redis-server /data/sentinel.conf --sentinel"- 원본(
/etc/redis/sentinel.conf)은 읽기 전용 마운트로 건드리지 않는다. - 시작 시
/data/sentinel.conf로 복사하고, Sentinel은 그 복사본을 읽고 쓴다.
Step 6. 지금까지의 설정 파일 정리
docker-compose.yml
# 인스턴스 A, B, C 각각에 Redis 1개 + Sentinel 1개를 배치한다.
x-sentinel: &sentinel
  image: redis:7
  command: sh -c "cp /etc/redis/sentinel.conf /data/sentinel.conf && exec redis-server /data/sentinel.conf --sentinel"

services:
  # ---------- 인스턴스 A ----------
  redis-a:
    image: redis:7
    container_name: redis-a
    command: redis-server --appendonly yes
    ports: ["6379:6379"]

  sentinel-a:
    <<: *sentinel
    container_name: sentinel-a
    volumes:
      - ./sentinel/sentinel-a.conf:/etc/redis/sentinel.conf:ro
    depends_on: [redis-a]
    ports: ["26379:26379"]

  # ---------- 인스턴스 B ----------
  redis-b:
    image: redis:7
    container_name: redis-b
    command: redis-server --appendonly yes --replicaof redis-a 6379
    depends_on: [redis-a]
    ports: ["6380:6379"]

  sentinel-b:
    <<: *sentinel
    container_name: sentinel-b
    volumes:
      - ./sentinel/sentinel-b.conf:/etc/redis/sentinel.conf:ro
    depends_on: [redis-a]
    ports: ["26380:26379"]

  # ---------- 인스턴스 C ----------
  redis-c:
    image: redis:7
    container_name: redis-c
    command: redis-server --appendonly yes --replicaof redis-a 6379
    depends_on: [redis-a]
    ports: ["6381:6379"]

  sentinel-c:
    <<: *sentinel
    container_name: sentinel-c
    volumes:
      - ./sentinel/sentinel-c.conf:/etc/redis/sentinel.conf:ro
    depends_on: [redis-a]
    ports: ["26381:26379"]
sentinel-a.conf
port 26379

# 인스턴스 A의 Sentinel. 다른 Sentinel/클라이언트에게 자신을 이 이름으로 알린다.
sentinel resolve-hostnames yes
sentinel announce-hostnames yes
sentinel announce-ip sentinel-a

# <name> <host> <port> <quorum>  (Sentinel 3개 → quorum=2)
sentinel monitor mymaster redis-a 6379 2
sentinel down-after-milliseconds mymaster 5000
sentinel failover-timeout mymaster 10000
sentinel parallel-syncs mymaster 1sentinel-b.conf, sentinel-c.conf 는 announce-ip 만 각각 sentinel-b, sentinel-c 로 바꾼다.
Sentinel 상태 확인
docker compose up -d
docker exec sentinel-a redis-cli -p 26379 sentinel master mymaster- num-slaves: 2
- num-other-sentinels: 2
- quorum: 2
docker exec sentinel-a redis-cli -p 26379 sentinel ckquorum mymaster- OK 3 usable Sentinels. Quorum and failover authorization can be reached
Step 7. Node.js 앱
index.js
const Redis = require("ioredis");

const redis = new Redis({
  sentinels: [
    { host: "sentinel-a", port: 26379 },
    { host: "sentinel-b", port: 26379 },
    { host: "sentinel-c", port: 26379 },
  ],
  name: "mymaster",
});
실제 코드는 환경변수(SENTINELS)로 주소를 받고, 1초마다 SET/GET을 하면서 어느 Master에 붙어있는지 로그를 찍는다.
setInterval(async () => {
  try {
    count += 1;
    await redis.set("counter", count);
    const value = await redis.get("counter");
    const master = redis.stream.remoteAddress;   // 지금 실제로 붙어있는 Master의 주소
    console.log(`[${new Date().toISOString()}] counter=${value} (master ${master})`);
  } catch (err) {
    console.error("command failed:", err.message);
  }
}, 1000);
Failover 도중에도 앱이 어떻게 반응하는지 보려는 용도다.
동작 순서
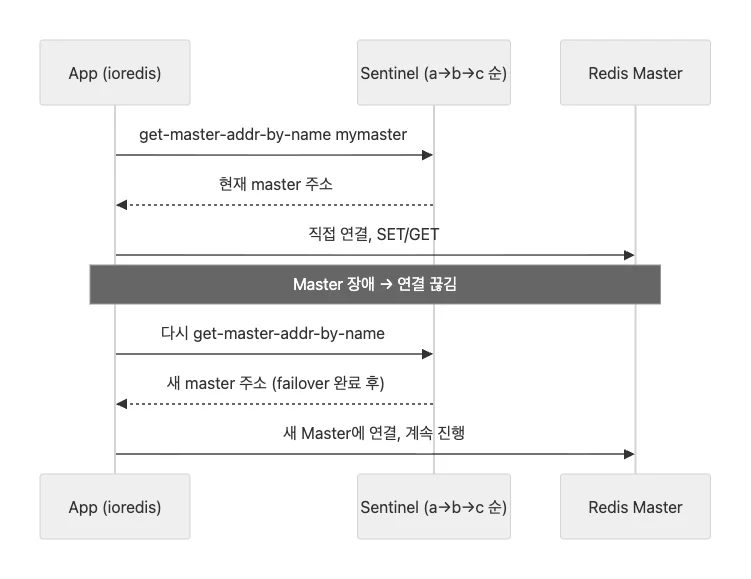
- 앱은 Sentinel을 통해 Master 위치만 알아내고, 데이터는 Master에 직접 주고받는다. Sentinel은 데이터 경로(proxy)가 아니다.
- 연결이 끊기면 ioredis가 알아서 Sentinel에 다시 물어본다. 애플리케이션 코드에는 failover 처리 로직이 없다.
- 첫 번째 Sentinel이 응답하지 않으면 다음 Sentinel로 넘어간다. (그래서 3개 모두 등록한다.)
컨테이너 파일
app:
  image: node:20
  container_name: sentinel-app
  working_dir: /app
  command: sh -c "npm install --no-audit --no-fund && node index.js"
  depends_on: [sentinel-a, sentinel-b, sentinel-c]
  environment:
    SENTINELS: "sentinel-a:26379,sentinel-b:26379,sentinel-c:26379"
  volumes:
    - ./app:/app
Step 8. 실행
docker compose up -d
docker compose logs -f app
2026-10-09 15:09:33 [2026-10-09T06:09:33.541Z] counter=1 (master 172.21.0.2)
2026-10-09 15:09:34 [2026-10-09T06:09:34.540Z] counter=2 (master 172.21.0.2)이벤트 정리
| 이벤트 | 앞 글의 단계 |
|---|---|
+sdown | 1. Master 장애 감지 (SDOWN) |
+odown ... #quorum 2/2 | 2. 여러 Sentinel이 확인 (ODOWN) |
+vote-for-leader, +elected-leader | 3. 리더 선출 |
+selected-slave, +promoted-slave | 4. Replica 승격 |
+switch-master | 4. 변경 이벤트 |
| 앱 로그의 master IP 변경 | 5. Client가 새 Master 사용 |
Step 9. Master 장애 상황
Sentinel에서 발생하는 이벤트들을 확인하기 위해서, Master를 종료시켰다.
2026-10-09 15:31:06 1:X 09 Oct 2026 06:31:06.253 # +sdown master mymaster redis-a 6379그러자 Sentinel들이 “어 우리 Master 죽은 것 같은데?” 라고 하면서 sdown 이벤트를 발생시켰다.
이후 sentinel-c 에서 아래와 같은 로그가 떴다.
06:31:02.136 # Failed to resolve hostname 'redis-a'
06:31:06.189 # +sdown master mymaster redis-a 6379
06:31:06.281 # +odown master mymaster redis-a 6379 #quorum 2/2
06:31:06.281 # +new-epoch 1
06:31:06.281 # +try-failover master mymaster redis-a 6379
06:31:06.283 # +vote-for-leader 6a7ff410... 1                  ← 자기 자신에게 투표
06:31:06.299 * 31637d23... voted for 6a7ff410... 1            ← sentinel-b의 투표
06:31:06.300 * 059f13cc... voted for 6a7ff410... 1            ← sentinel-a의 투표
06:31:06.336 # +elected-leader master mymaster redis-a 6379
06:31:06.415 # +selected-slave slave 172.22.0.7:6379 ...
06:31:06.815 # +promoted-slave slave 172.22.0.7:6379 ...
06:31:07.739 # +failover-end master mymaster redis-a 6379
06:31:07.739 # +switch-master mymaster redis-a 6379 172.22.0.7 6379
06:31:07.756 * +slave slave redis-a:6379 ... @ mymaster 172.22.0.7 6379   ← 옛 master가 replica로 등록
이 로그에서 확인할 수 있는 것들은 다음과 같다.
Sentinel ID is 6a7ff410... 이 로그 주인의 ID인데, 세 Sentinel이 모두 이 ID에 투표했다. 리더가 미리 정해져 있는 게 아니라 ODOWN을 가장 먼저 확인한 Sentinel이 먼저 선거에 나서고, 과반 표를 받으면 리더가 된다. 뒤에 붙은 1은 선거 회차(epoch)다.
이후 selected-slave (후임자 지명) → promoted-slave (취임) → switch-master (인사 발령 공지) 순으로 이벤트가 발생했다. 새 master는 127.22.0.7 이 되었다.
이후 죽었던 master(redis-a)가 돌아올 경우, 옛 Master는 Replica로 합류한다.
redis-a는 --replicaof 없이 시작했지만, Senitnel이 REPLICAOF 명령을 내려서 새 Master의 Replica로 강등시킨다고 한다.
Step 10. 과반수를 충족하지 못하는 경우
만약 redis-a가 죽었을 때, sentinel 2개가 장애 상황일 경우에는 어떨까?
결론부터 말하면, sentinel 하나만으로는 과반수를 충족하지 못해 sdown만 뜨고 odown이 뜨지 않는 것을 확인할 수 있다.
2026-10-09 15:51:07 1:X 09 Oct 2026 06:51:07.061 # +sdown sentinel 7384b91346804e04212a84f4803e3029c1a1850e sentinel-b 26379 @ mymaster redis-a 6379
2026-10-09 15:51:07 1:X 09 Oct 2026 06:51:07.672 # +sdown sentinel 84e73a727f38c53a10b81d0be8ebe4608591ea59 sentinel-c 26379 @ mymaster redis-a 6379
2026-10-09 15:51:10 1:X 09 Oct 2026 06:51:10.261 # +sdown master mymaster redis-a 6379
Step 11. Split Brain 문제
Split Brain은 네트워크 단절 등으로 인해 기존 Master와 새 Master가 동시에 쓰기 요청을 처리할 수 있는 상태를 의미한다.
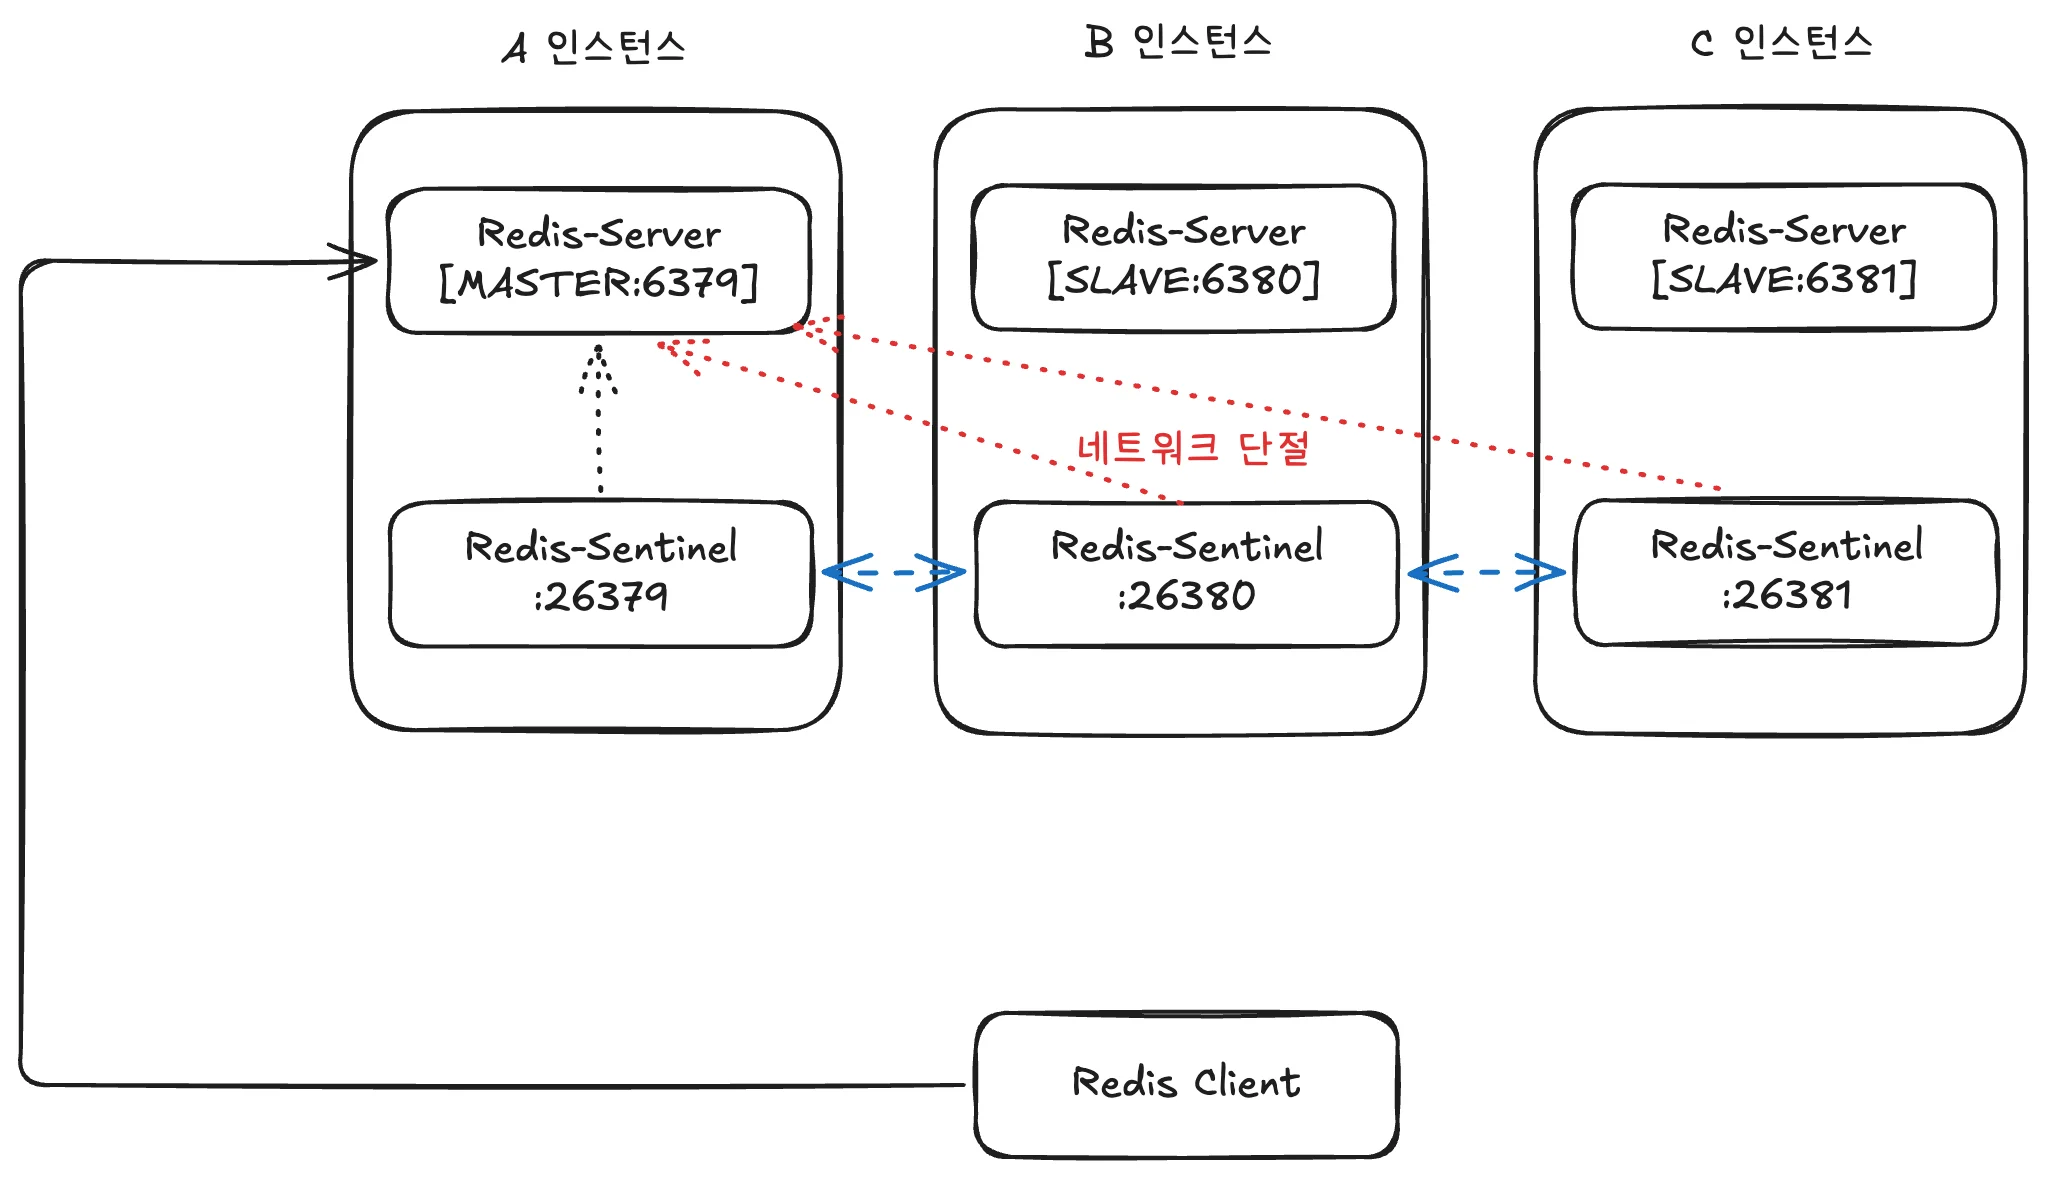
기존 Master A와 Replica B, C 사이의 네트워크가 단절되었다고 가정하자. B, C의 Sentinel은 A를 장애 상태로 판단하고 B를 새로운 Master로 승격시킨다. 하지만 기존 Master A는 여전히 클라이언트의 쓰기 요청을 처리할 수 있다.
이때 A와 B에서 각각 쓰기가 발생하면 두 Master는 서로 다른 데이터를 갖게 된다.
이후 네트워크가 복구되면 Sentinel은 기존 A를 새 Master B의 Replica로 재구성할 수 있다. 이 과정에서 A에만 존재했던 데이터가 유실될 수 있다.
즉, Sentinel을 사용하더라도 네트워크 단절 상황에서 Split Brain과 데이터 유실 가능성이 완전히 사라지는 것은 아니다.
마무리하며
개인적으로 이번 실습에서 가장 재미있었던 부분은 Sentinel들이 서로 투표하고, 리더를 선출하고, 새로운 Master를 받아들이는 과정이었다.
단순히 장애가 발생하면 다른 서버로 전환되는 줄 알았는데, 그 과정에서도 장애를 판단하고, 의견을 모으고, 리더를 뽑는 일련의 절차가 있다는 게 흥미로웠다. 마치 작은 사회가 돌아가는 모습을 보는 것 같았다.
물론 실제 사회와는 다르게 정해진 규칙과 알고리즘에 따라 동작하지만, 여러 구성원이 서로의 상태를 확인하고 합의를 통해 하나의 결정을 내린다는 점이 인상적이었다.
이번 실습을 통해 Redis Sentinel의 동작 원리를 이해한 것도 좋았지만, 평소에는 당연하게 사용하던 시스템 뒤에서 이런 과정들이 일어나고 있다는 것을 직접 확인할 수 있어서 재미있었다.
참고 자료
- https://github.com/JangDongHo/redis-sentinel-practice
- https://co-de.tistory.com/15
- https://redis.io/docs/latest/operate/oss_and_stack/management/sentinel/
- https://redis.io/docs/latest/operate/oss_and_stack/management/replication/
- https://github.com/redis/ioredis
- https://ioredis.readthedocs.io/en/latest/API/